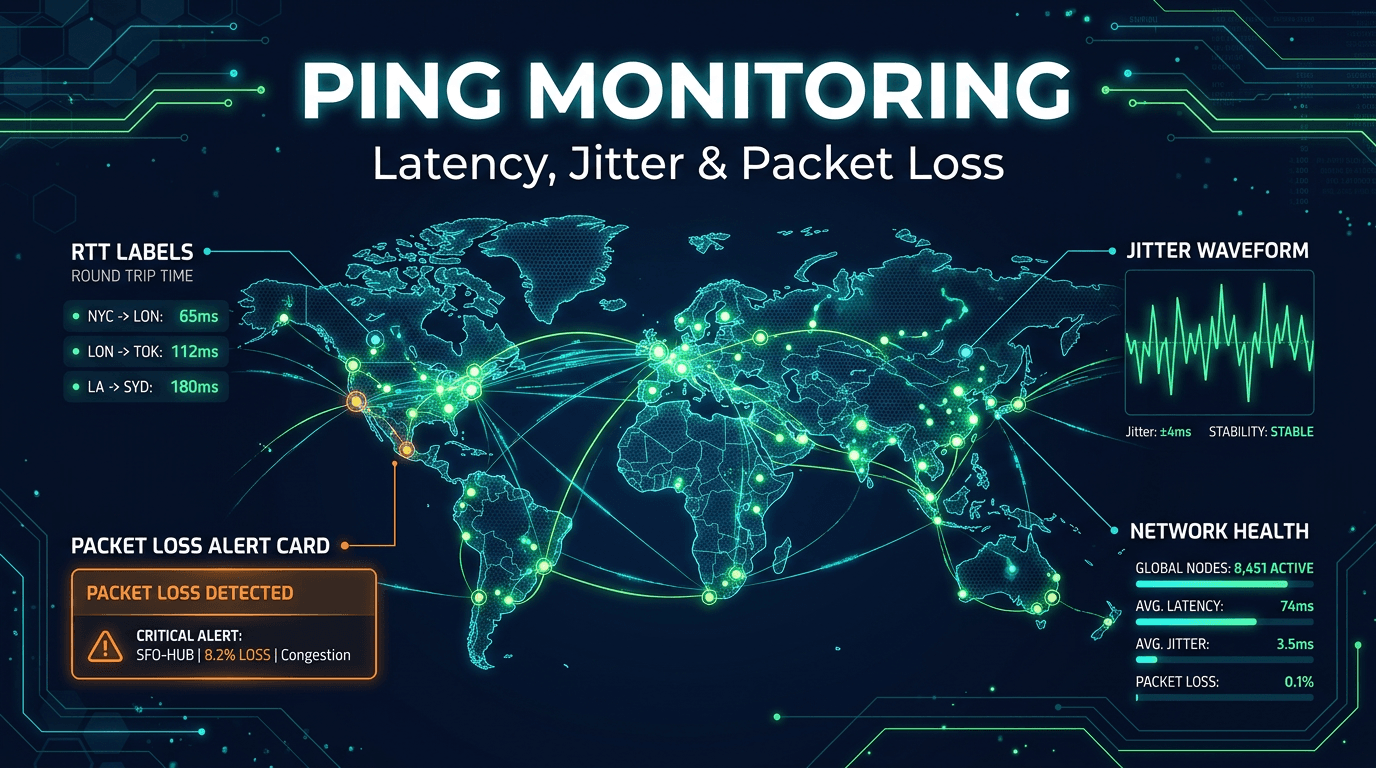
Comment surveiller la perte de paquets et la latence entre les régions du monde ?
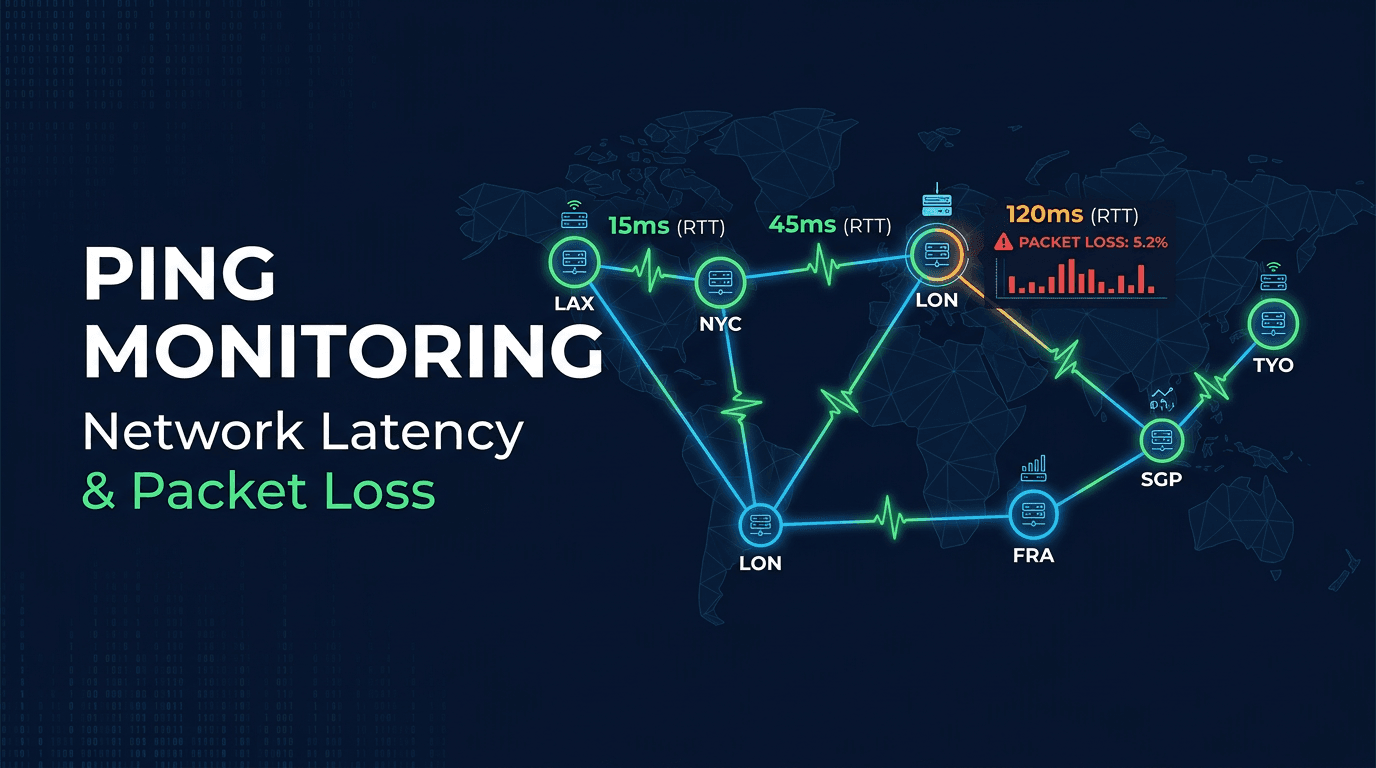
Surveillez perte de paquets et latence à l'échelle mondiale : sondes proches des utilisateurs, références par région, suivi du p95 et de la gigue, alertes par quorum.
Connexion client
Connexion10 articles de blog avec le tag « Surveillance ping ».
Comment surveiller la perte de paquets et la latence entre les régions du monde ?
Surveillez perte de paquets et latence à l'échelle mondiale : sondes proches des utilisateurs, références par région, suivi du p95 et de la gigue, alertes par quorum.
Le monitoring ping repère tôt la hausse de latence, la gigue, les pertes de paquets intermittentes et les changements de route, pour corriger avant une panne visible.
Quels sont les meilleurs outils de monitoring ping pour serveurs, routeurs et sites web ?
Un bon monitoring ping associe un moniteur externe multi-sites pour les sites web à un outil interne SNMP pour les routeurs. Comparatif des types d'outils.
Qu'est-ce que le monitoring ping et quand l'utiliser plutôt que des vérifications HTTP ?
Le monitoring ping vérifie qu'un hôte est joignable au niveau réseau. Quand un ping ICMP, TCP ou UDP surpasse les checks HTTP, et pourquoi combiner les deux.
Quels seuils de monitoring ping définir pour détecter rapidement les incidents ?
Commencez avec un intervalle de 30 à 60 s, 2 à 3 échecs consécutifs, un quorum de 2 sites sur 3, des alertes de latence à 2x et 3x la référence et de perte à 2 % et 10 %.
Pourquoi la surveillance ping reste-t-elle importante dans les environnements cloud et Kubernetes ?
Le cloud et Kubernetes n'empêchent pas les pannes réseau. Les checks ping et TCP repèrent les erreurs de security groups, NAT, peering, DNS et régions.
Comment créer une stratégie de surveillance multi-régions pour la fiabilité du SaaS
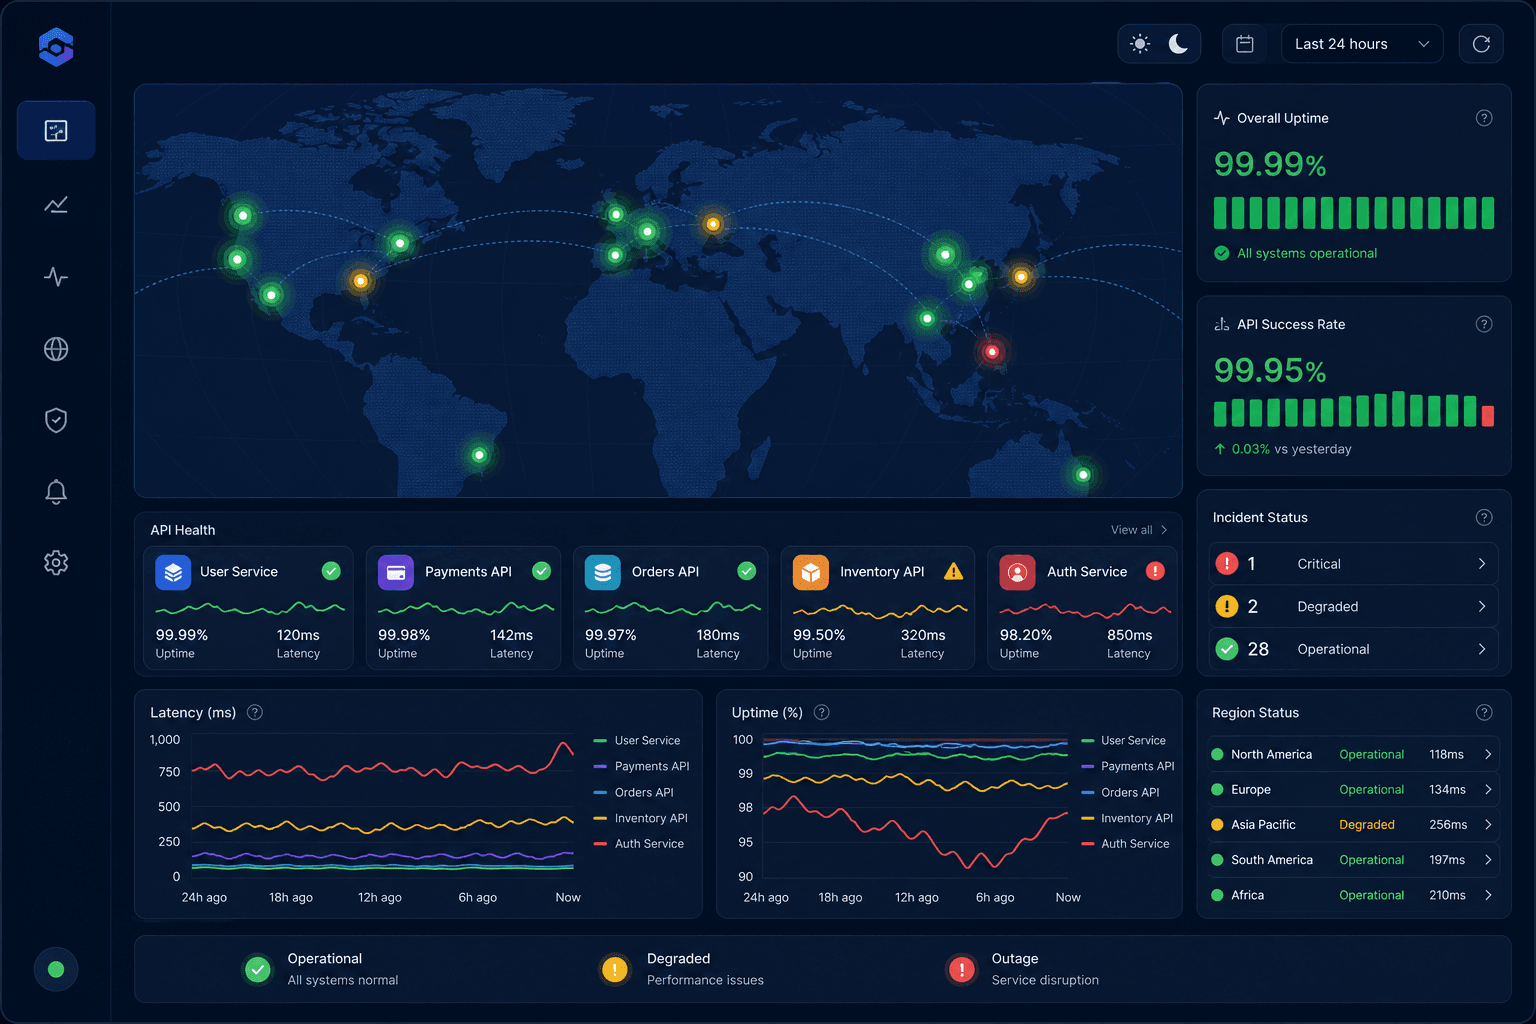
Découvrez comment les équipes SaaS peuvent élaborer une stratégie de surveillance multirégionale qui détecte plus rapidement les pannes régionales, la dégradation des API, les pics de latence et les problèmes de fiabilité impactant les utilisateurs.
Guide de surveillance Ping : latence, perte de paquets et accessibilité du réseau
Découvrez comment fonctionne la surveillance ping : mesurez la latence du réseau, détectez la perte de paquets, suivez la gigue et surveillez l'accessibilité du serveur à partir de plusieurs emplacements mondiaux avec le ping ICMP et TCP.
Un guide pratique sur la surveillance de la latence du réseau en 2026, couvrant le RTT, la gigue, la perte de paquets, l'analyse régionale, les seuils d'alerte et la manière de détecter rapidement les chemins lents.
Découvrez les meilleures pratiques de surveillance du ping pour 2026, notamment comment suivre la latence, la gigue, la perte de paquets, l'accessibilité multirégionale et la dégradation précoce du réseau.
Ce hub « Surveillance ping » regroupe les derniers articles UpScanX pour passer de la curiosité à la mise en œuvre sans fouiller tout l’archive. La page 1 liste jusqu’à 20 articles parmi 10 sur ce sujet.
Peu d’équipes traitent la fiabilité avec un seul contrôle. Il faut une responsabilité claire, des alertes utiles, de l’analyse de tendances et relier les signaux techniques à l’impact utilisateur. D’où l’intérêt durable des pages thématiques.
Plusieurs angles sur un même sujet permettent de comparer les approches — disponibilité, réduction du bruit d’alertes, sécurité ou montée en charge des opérations.
Les meilleurs articles insistent sur des systèmes concrets, des compromis mesurables et des habitudes reproductibles : quoi surveiller, comment alerter, éviter les interruptions et lier les choix techniques aux résultats business.
Utilisez cette page comme un mini parcours : commencez par l’article le plus proche de votre problème, puis les guides liés.