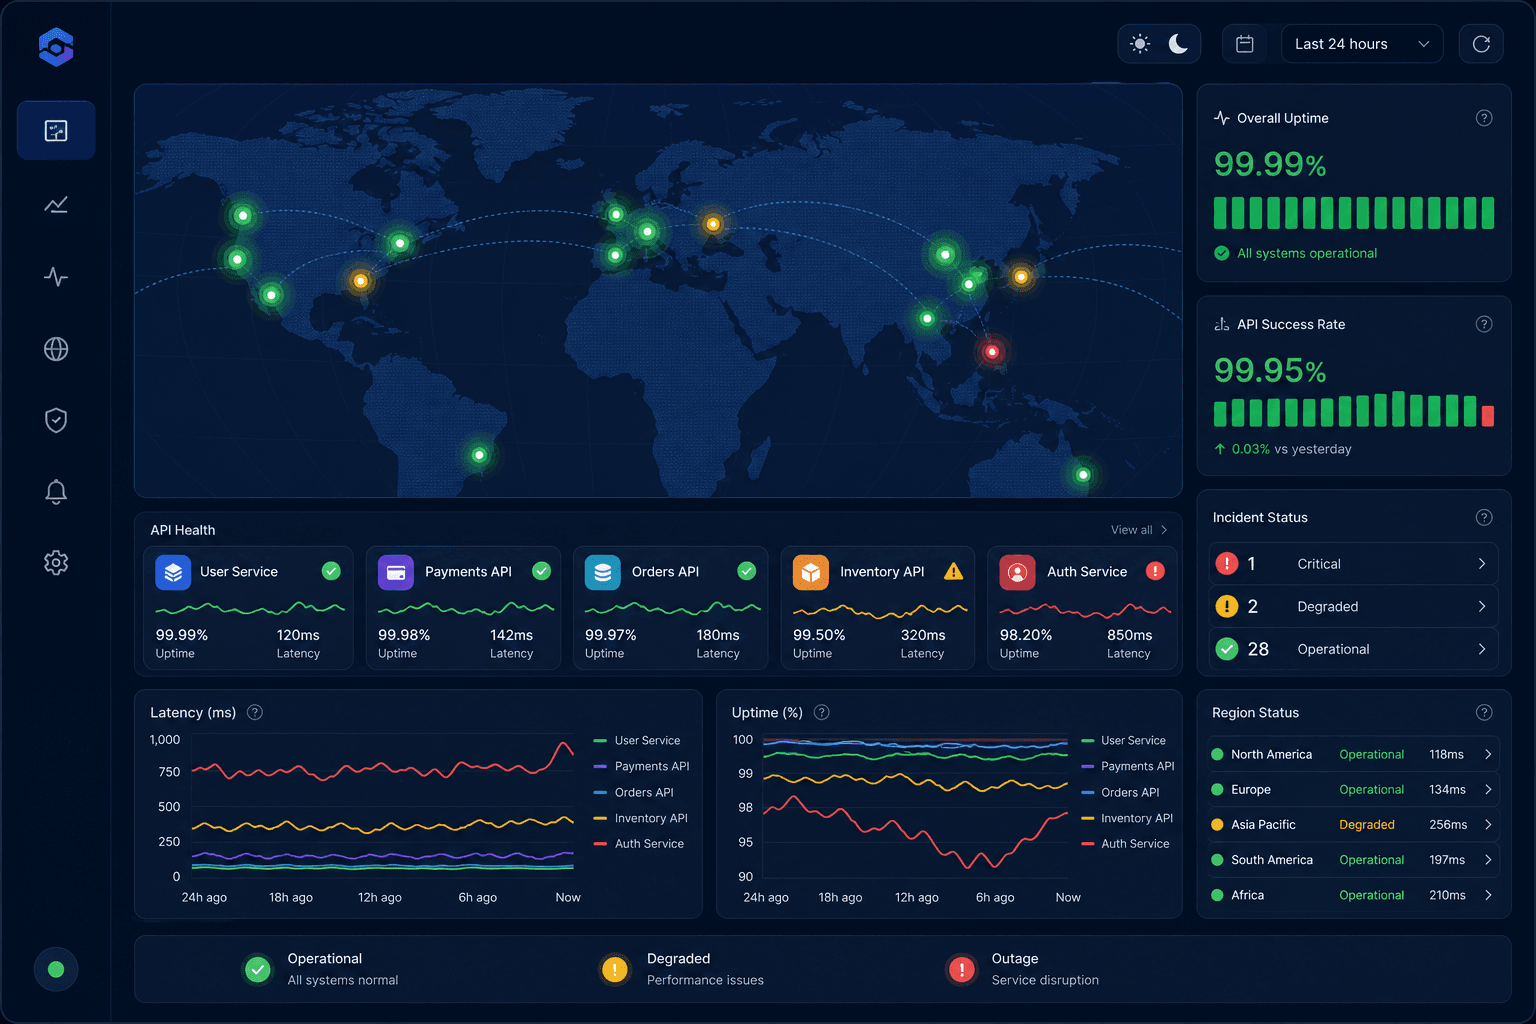
Каковы лучшие практики проектирования аналитического дашборда для мониторинга?
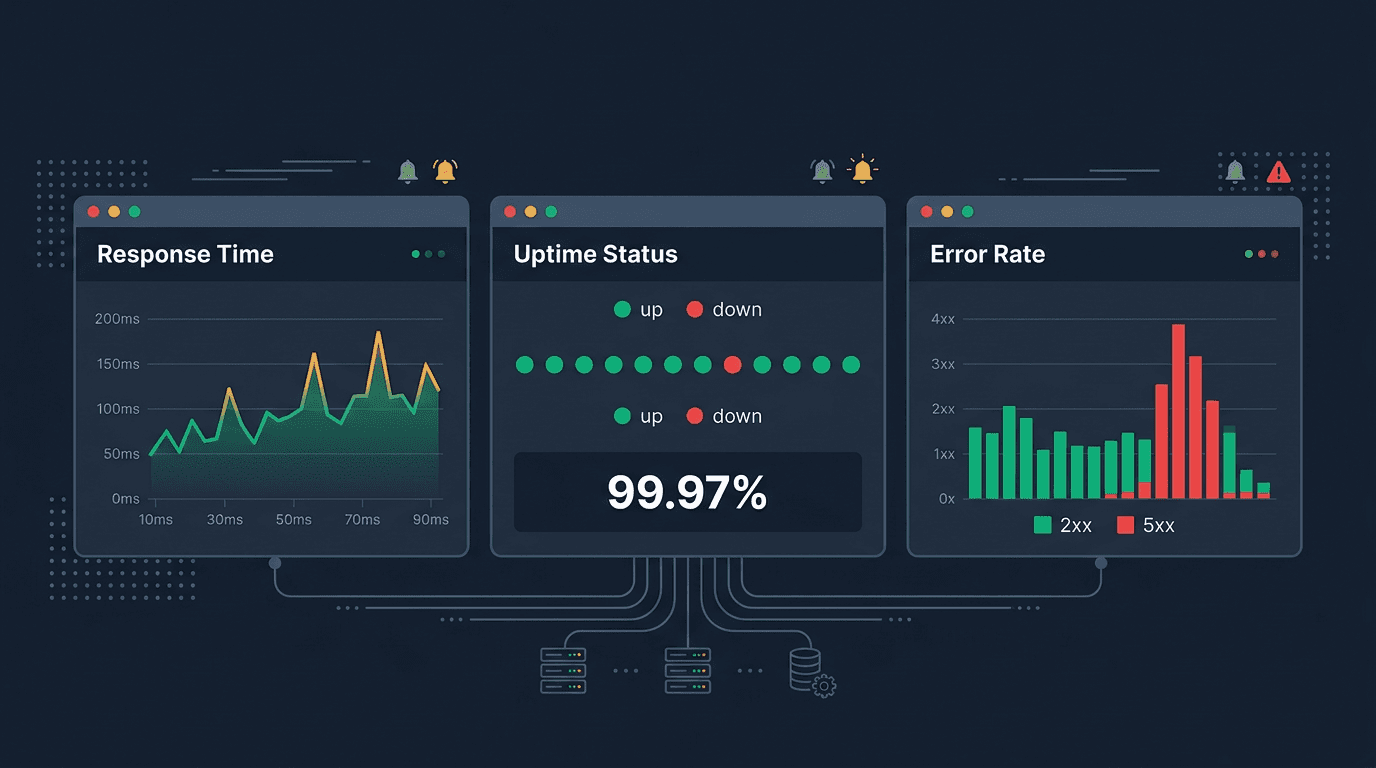
Стройте дашборды мониторинга вокруг вопросов аудитории: сводка сверху, 5–9 панелей, единые единицы, перцентили, видимые пороги и переход к деталям.
Вход для клиентов
Войти29 постов в блоге с тегом «Мониторинг производительности».
Каковы лучшие практики проектирования аналитического дашборда для мониторинга?
Стройте дашборды мониторинга вокруг вопросов аудитории: сводка сверху, 5–9 панелей, единые единицы, перцентили, видимые пороги и переход к деталям.
Каким сценариям мониторинга больше всего помогают отчёты, сгенерированные ИИ?
ИИ-отчёты полезнее всего при инцидентах с множеством сигналов, отчётности по SLA, медленной деградации, портфелях SSL и доменов, сторонних API и для агентств.
Как отслеживать потерю пакетов и задержку в разных регионах мира?
Отслеживайте потери пакетов и задержку глобально: точки проверки рядом с пользователями, базовые уровни по регионам, p95 и джиттер вместо средних, оповещения по кворуму.
Как сбои API влияют на пользовательский опыт, выручку и удержание клиентов?
Сбои в работе API и скачки задержки — это тихие убийцы современных SaaS-компаний. Узнайте, как сбои API ухудшают пользовательский опыт, приводят к потере выручки из-за нежелательного оттока и разрушают удержание клиентов.
Каковы лучшие инструменты мониторинга API для стартапов и корпоративных команд?
Откройте для себя лучшие инструменты мониторинга API для стартапов и корпоративных команд в 2026 году. Сравните Datadog, Checkly, Moesif, Better Stack и Treblle, чтобы найти идеальный вариант наблюдения, подходящий для вашего стека.
Как построить межрегиональную стратегию мониторинга надежности SaaS
Узнайте, как команды SaaS могут создать стратегию мониторинга в нескольких регионах, которая быстрее выявляет региональные сбои, ухудшение API, скачки задержек и проблемы с надежностью, влияющие на пользователей.
Как разработать стратегию мониторинга API для общедоступных и частных конечных точек?
Узнайте, как создать стратегию мониторинга API, охватывающую как общедоступные, так и частные конечные точки, включая обработку аутентификации, методы доступа для внутренних API, отдельные SLO, соображения безопасности и унифицированную видимость.
Узнайте, как отслеживать время ответа API, время безотказной работы и частоту ошибок в режиме реального времени с помощью синтетических проверок, многорегиональных зондирований, процентных панелей мониторинга, классификации ошибок, пороговых значений оповещений и рабочих процессов реагирования на инциденты.
Какие оповещения мониторинга API сокращают время реагирования на инциденты больше всего?
Узнайте, какие оповещения мониторинга API сокращают время реагирования на инциденты больше всего: от сбоев доступности в нескольких регионах и резких скачков частоты ошибок до нарушений процентилей задержек, предупреждений о зависимостях и сбоев проверки ответов.
Почему мониторинг сторонних API необходим для современных SaaS-продуктов?
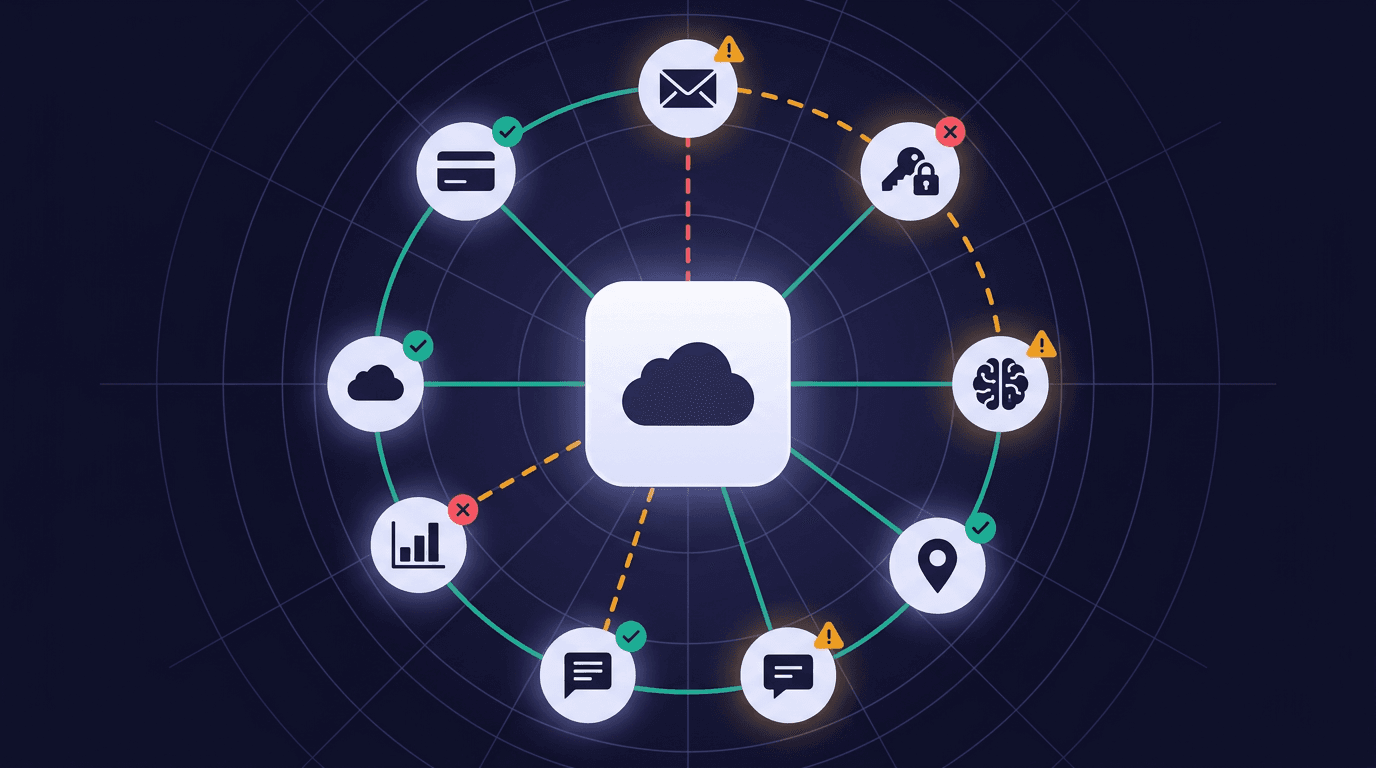
Узнайте, почему сторонний мониторинг API важен для продуктов SaaS, как сбои внешних зависимостей влияют на ваших клиентов и как создать мониторинг, защищающий от сбоев в работе поставщиков, которые вы не можете контролировать.
Что такое мониторинг API и какие показатели наиболее важны для надежности?
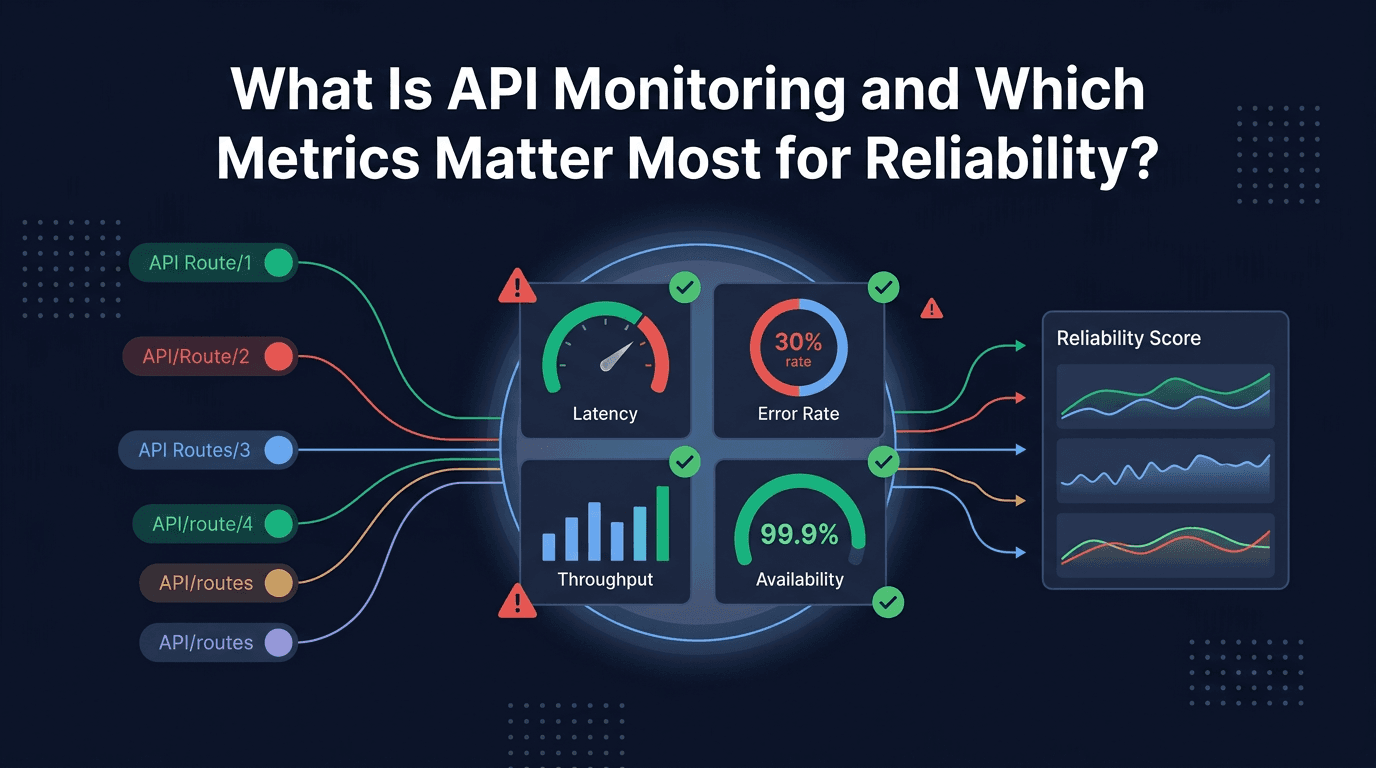
Узнайте, что такое мониторинг API и какие показатели наиболее важны для надежности, включая доступность, процентили задержки, частоту ошибок, время до первого байта, пропускную способность, частоту тайм-аутов и работоспособность зависимостей.
Каковы лучшие методы мониторинга работоспособности веб-сайтов для сайтов электронной торговли?
Изучите лучшие методы мониторинга работоспособности веб-сайтов для сайтов электронной коммерции, включая мониторинг оформления заказов, проверку корзины, отслеживание зависимостей платежей, региональные проверки и защиту SEO.
Почему 99,9% времени безотказной работы недостаточно для современных веб-сайтов?
Узнайте, почему 99,9 % времени безотказной работы уже недостаточно для современных веб-сайтов, как время простоя влияет на доход, SEO и доверие, а также к каким целевым показателям надежности следует стремиться вместо этого.
Как вы отслеживаете время безотказной работы веб-сайта в нескольких точках по всему миру?
Узнайте, как отслеживать время безотказной работы веб-сайта в нескольких точках по всему миру, почему региональные проверки важны и как уменьшить количество ложных срабатываний, одновременно защищая SEO и пользовательский опыт.
Сколько времени простоя приемлемо, прежде чем это повлияет на рейтинг Google?
Узнайте, сколько простоев веб-сайта допустимо, прежде чем это повлияет на рейтинг Google, как сбои влияют на сканирование и индексацию, а также что командам следует делать, чтобы снизить риски SEO.
Что такое мониторинг работоспособности веб-сайта и почему это важно для SEO?
Узнайте, что такое мониторинг работоспособности веб-сайта, как он работает и почему это важно для SEO, сканируемости, доверия пользователей и долгосрочного органического роста.
Какие показатели работоспособности веб-сайта следует отслеживать командам SaaS в первую очередь?
Узнайте, какие показатели работоспособности веб-сайта команды SaaS должны отслеживать в первую очередь, включая доступность, задержку, частоту ошибок, MTTR и сигналы воздействия на пользователей, которые повышают надежность.
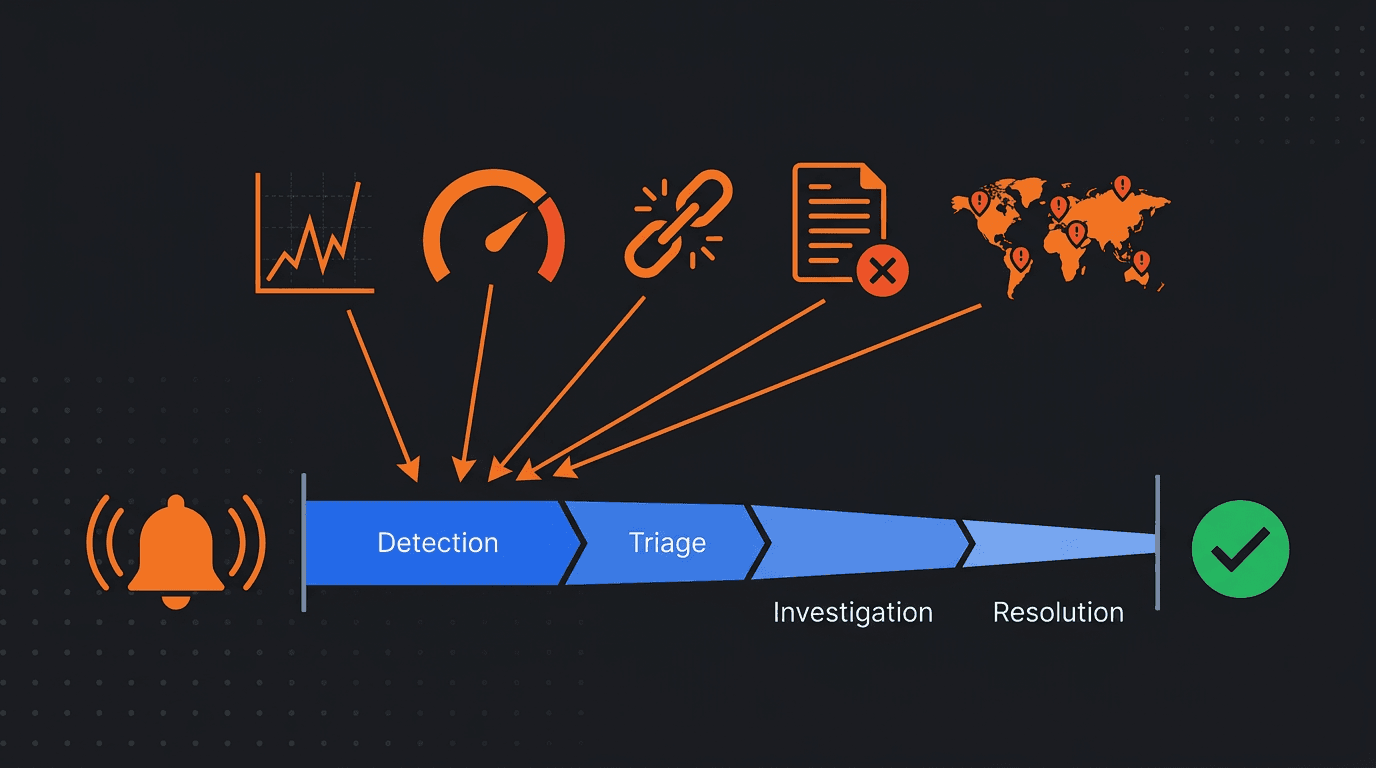
Узнайте, как в 2026 году будут работать отчеты о мониторинге на основе искусственного интеллекта, включая обнаружение аномалий, корреляцию предупреждений, анализ первопричин, прогнозную информацию и более интеллектуальную оперативную отчетность.
Лучшие практики мониторинга API на 2026 год: P95, P99, синтетические проверки и проверка ответов
Практическое руководство 2026 года по передовым практикам мониторинга API, включая проверки REST и GraphQL, задержку P95 и P99, синтетические рабочие процессы, проверку схемы, SLO и разработку оповещений.
Практическое руководство по мониторингу API SLO на 2026 год, охватывающее цели уровня обслуживания, бюджеты ошибок, задержки P95 и P99, оповещения и способы согласования мониторинга API с реальным воздействием на пользователей.
Раздел «Мониторинг производительности» собирает свежие статьи UpScanX: от интереса к внедрению без просмотра всего архива. Страница 1 показывает до 20 из 29 материалов по теме.
Надёжность редко решается одной проверкой. Нужны ответственность, полезные алерты, анализ трендов и связь сигналов с влиянием на пользователей. Поэтому тематические страницы остаются ценными.
Разные углы одной темы помогают сравнивать подходы: доступность, шум алертов, безопасность или масштабирование операций.
Сильные материалы опираются на практику, измеримые компромиссы и привычки: что мониторить, как алертить, как снижать простои и как инженерные решения влияют на бизнес.
Используйте страницу как короткий маршрут: сначала статья ближе всего к вашей задаче, затем связанные гайды.