Зачем командам единый аналитический дашборд для мониторинга инфраструктуры?
Единый дашборд объединяет данные об аптайме, SSL, доменах, сети и трафике, сокращая переключение контекста, дубли алертов и время корреляции при инцидентах.
Вход для клиентов
Войти35 постов в блоге с тегом «Мониторинг инфраструктуры».
Зачем командам единый аналитический дашборд для мониторинга инфраструктуры?
Единый дашборд объединяет данные об аптайме, SSL, доменах, сети и трафике, сокращая переключение контекста, дубли алертов и время корреляции при инцидентах.
Как мониторинг портов выявляет скрытые сбои раньше, чем HTTP-мониторинг?
Мониторинг портов находит скрытые сбои, которые пропускают HTTP-проверки: упавшие порты БД и очередей, медленный TCP, отказ реплик и изменения файрвола.
Как мониторить открытые порты веб-серверов, баз данных и почтовых сервисов?
Мониторьте порты веба, баз данных и почты, проверяя ответ протокола, а не только TCP-подключение, и получайте алерт, если база данных стала доступна из интернета.
Какие инструменты мониторинга портов лучше всего подходят для DevOps- и ИТ-команд?
Лучшие инструменты мониторинга портов сочетают проверки TCP/UDP, валидацию протокола и обнаружение изменений. Сравниваем сканеры, self-hosted и SaaS.
Что такое мониторинг портов и почему он важен для надёжности сети?
Мониторинг портов проверяет, принимает ли сервис соединения на конкретном порту TCP или UDP. Узнайте, какие сбои он выявляет, которые пропускают ping и HTTP-проверки.
Какие порты мониторить в первую очередь в продакшн-инфраструктуре?
Сначала публичные точки входа (443, 80, API, DNS, SMTP), затем внутренние БД, кэши и очереди, затем порты управления, которые не должны быть публичными.
Как отслеживать потерю пакетов и задержку в разных регионах мира?
Отслеживайте потери пакетов и задержку глобально: точки проверки рядом с пользователями, базовые уровни по регионам, p95 и джиттер вместо средних, оповещения по кворуму.
Как ping-мониторинг помогает обнаружить сетевые проблемы раньше, чем их заметят пользователи?
Ping-мониторинг рано выявляет рост задержки, джиттер, периодические потери пакетов и смену маршрутов, чтобы устранить деградацию сети до заметного сбоя.
Какие инструменты ping-мониторинга лучше всего подходят для серверов, маршрутизаторов и сайтов?
Оптимальный ping-мониторинг сочетает внешний сервис с проверками из многих локаций для сайтов и внутренний SNMP-инструмент для маршрутизаторов.
Что такое пинг-мониторинг и когда использовать его вместо HTTP-проверок?
Пинг-мониторинг проверяет доступность хоста на сетевом уровне. Когда ICMP-, TCP- или UDP-ping полезнее HTTP-проверок и почему их стоит сочетать.
Какие пороги ping-мониторинга задать для быстрого обнаружения инцидентов?
Начните с интервала 30–60 с, 2–3 сбоев подряд, кворума 2 из 3 локаций, алертов по задержке на 2x и 3x от базовой линии и по потере пакетов на 2% и 10%.
Почему ping-мониторинг по-прежнему важен в облачных средах и Kubernetes?
Облако и Kubernetes не отменяют сетевых сбоев. Ping- и TCP-проверки находят проблемы с security groups, NAT, peering, DNS и регионами, которые пропускают пробы.
Каковы лучшие инструменты мониторинга API для стартапов и корпоративных команд?
Откройте для себя лучшие инструменты мониторинга API для стартапов и корпоративных команд в 2026 году. Сравните Datadog, Checkly, Moesif, Better Stack и Treblle, чтобы найти идеальный вариант наблюдения, подходящий для вашего стека.
Как разработать стратегию мониторинга API для общедоступных и частных конечных точек?
Узнайте, как создать стратегию мониторинга API, охватывающую как общедоступные, так и частные конечные точки, включая обработку аутентификации, методы доступа для внутренних API, отдельные SLO, соображения безопасности и унифицированную видимость.
Почему мониторинг сторонних API необходим для современных SaaS-продуктов?
Узнайте, почему сторонний мониторинг API важен для продуктов SaaS, как сбои внешних зависимостей влияют на ваших клиентов и как создать мониторинг, защищающий от сбоев в работе поставщиков, которые вы не можете контролировать.
Как изменения DNS домена могут повлиять на доступность веб-сайта и SEO?
Узнайте, как изменения DNS влияют на доступность веб-сайта и производительность SEO: от неправильных настроек записи A и изменений сервера имен до ошибок TTL, сбоев CNAME и сбоев сканирования во время миграции.
Каковы лучшие практики мониторинга доменов в 2026 году?
Комплексное руководство по передовым практикам мониторинга доменов в 2026 году, охватывающее операционную зрелость, межфункциональное владение, стратегии автоматизации, сложность мультиоблачного DNS, требования соответствия и интегрированные рабочие процессы мониторинга.
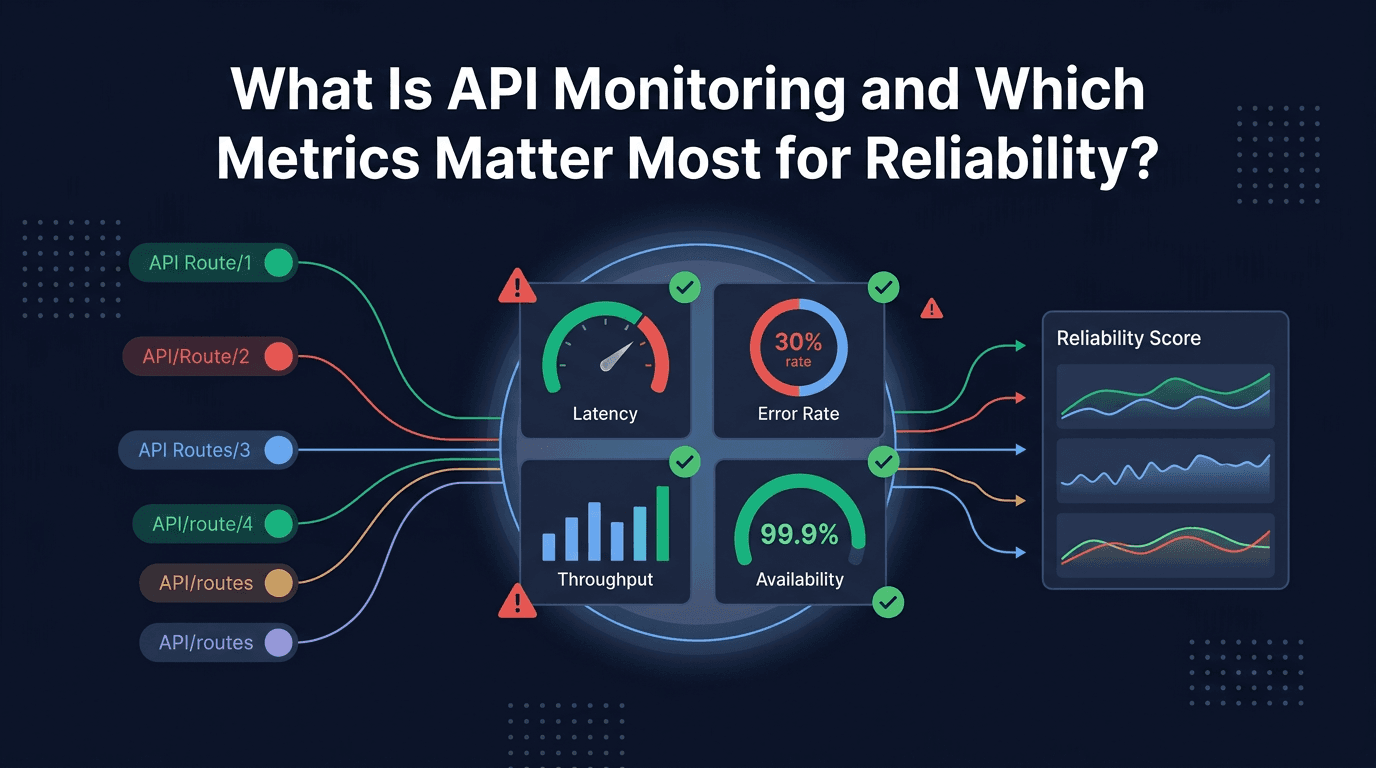
Что такое мониторинг API и какие показатели наиболее важны для надежности?
Узнайте, что такое мониторинг API и какие показатели наиболее важны для надежности, включая доступность, процентили задержки, частоту ошибок, время до первого байта, пропускную способность, частоту тайм-аутов и работоспособность зависимостей.
Какие оповещения о мониторинге домена наиболее важны для ИТ-отделов и маркетинговых команд?
Узнайте, какие оповещения при мониторинге домена должны быть приоритетными для ИТ- и маркетинговых команд: от изменений DNS-записей и изменений серверов имен до предупреждений об истечении срока действия, сбоев аутентификации электронной почты и событий, влияющих на SEO.
Как вы контролируете срок действия домена для нескольких брендов или клиентов?
Узнайте, как отслеживать истечение срока действия домена для нескольких брендов или клиентов с помощью централизованного инвентаря, отслеживания прав собственности, контроля регистраторов, рабочих процессов продления и многоуровневых оповещений.
Раздел «Мониторинг инфраструктуры» собирает свежие статьи UpScanX: от интереса к внедрению без просмотра всего архива. Страница 1 показывает до 20 из 35 материалов по теме.
Надёжность редко решается одной проверкой. Нужны ответственность, полезные алерты, анализ трендов и связь сигналов с влиянием на пользователей. Поэтому тематические страницы остаются ценными.
Разные углы одной темы помогают сравнивать подходы: доступность, шум алертов, безопасность или масштабирование операций.
Сильные материалы опираются на практику, измеримые компромиссы и привычки: что мониторить, как алертить, как снижать простои и как инженерные решения влияют на бизнес.
Используйте страницу как короткий маршрут: сначала статья ближе всего к вашей задаче, затем связанные гайды.