
par Équipe éditoriale UpScanX
Un tableau de bord de monitoring en sept étapes : recenser pages, API et certificats, fixer des SLO, harmoniser les checks, organiser par couche, alerter, réviser.


Connexion client
Connexion13 articles de blog avec le tag « Surveillance des API ».
Un tableau de bord de monitoring en sept étapes : recenser pages, API et certificats, fixer des SLO, harmoniser les checks, organiser par couche, alerter, réviser.
Que doit contenir un bon rapport IA après un incident de disponibilité ou d'API ?
Un bon rapport d'incident IA couvre l'impact, la chronologie, les signaux corrélés, la cause probable avec confiance et preuves, les inconnues et les actions.
Comment les pannes d'API affectent-elles l'expérience client, les revenus et la rétention ?
Les pannes d'API et les pics de latence sont les tueurs silencieux des entreprises SaaS modernes. Découvrez comment les pannes d'API dégradent l'expérience client, entraînent des pertes de revenus par désabonnement involontaire et détruisent la rétention des utilisateurs.
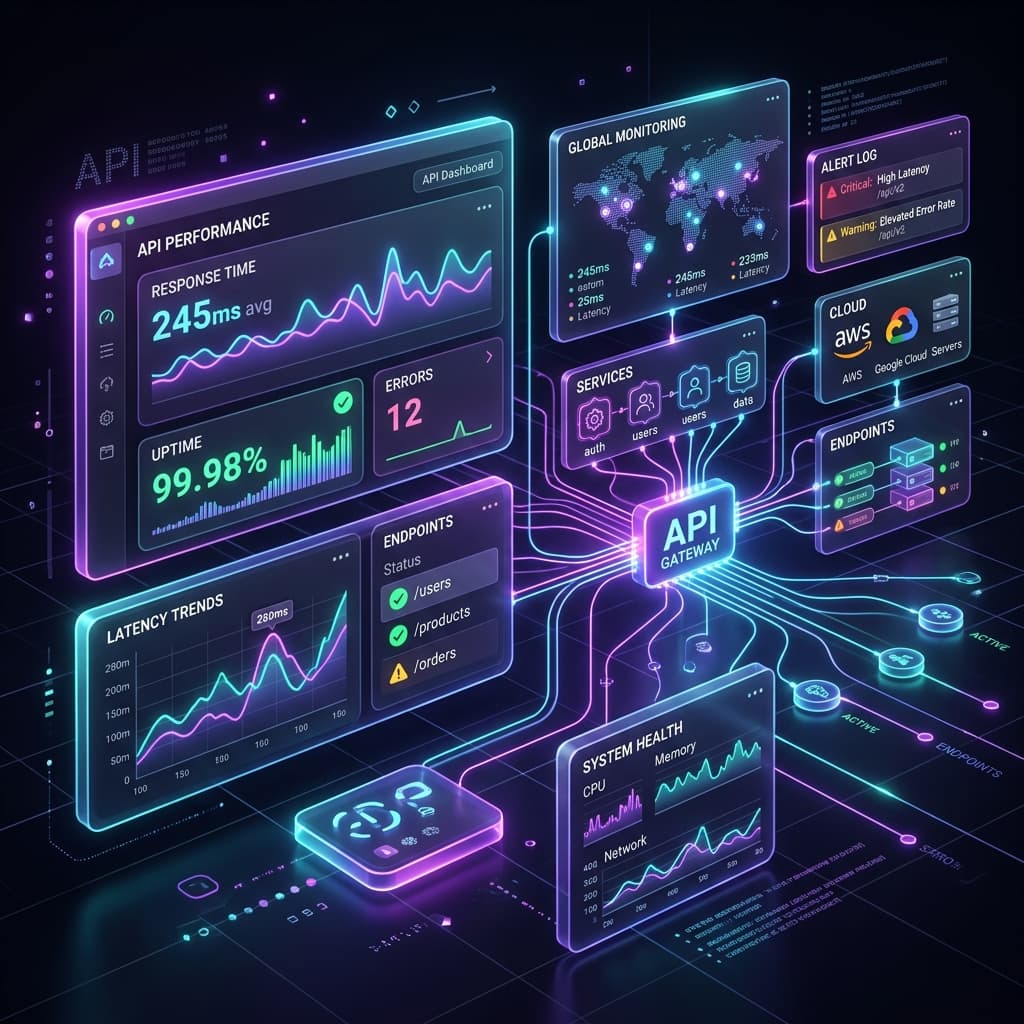
Découvrez les meilleurs outils de surveillance des API pour les startups et les équipes d'entreprise en 2026. Comparez Datadog, Checkly, Moesif, Better Stack et Treblle pour trouver l'observabilité parfaite pour votre pile.
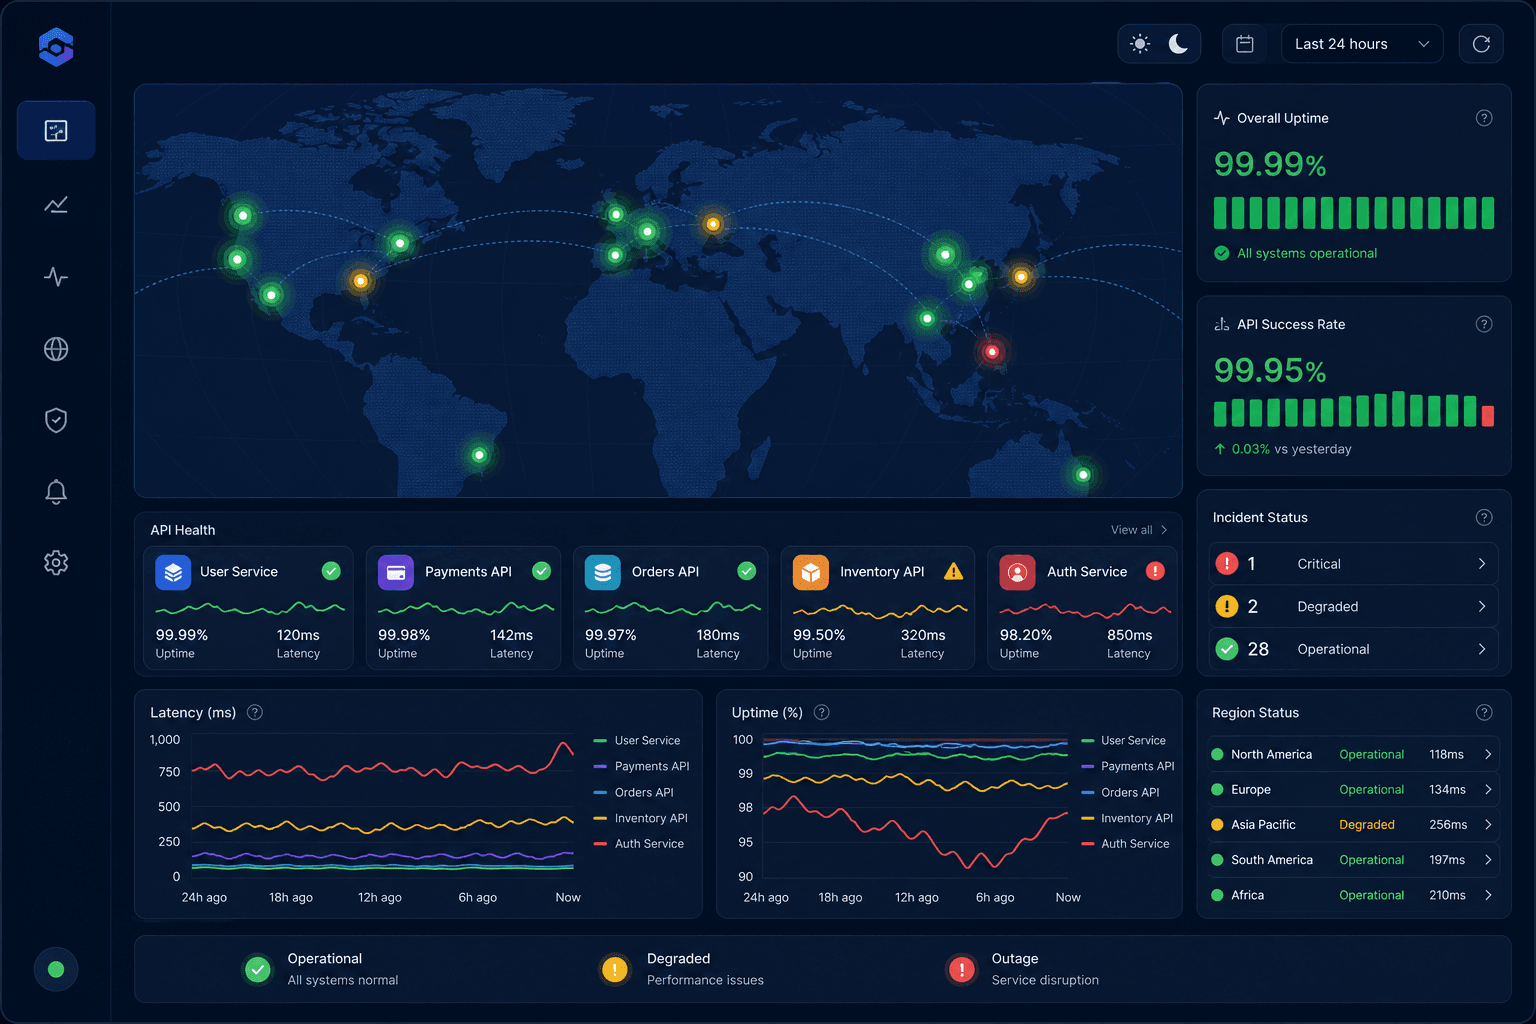
Comment créer une stratégie de surveillance multi-régions pour la fiabilité du SaaS
Découvrez comment les équipes SaaS peuvent élaborer une stratégie de surveillance multirégionale qui détecte plus rapidement les pannes régionales, la dégradation des API, les pics de latence et les problèmes de fiabilité impactant les utilisateurs.
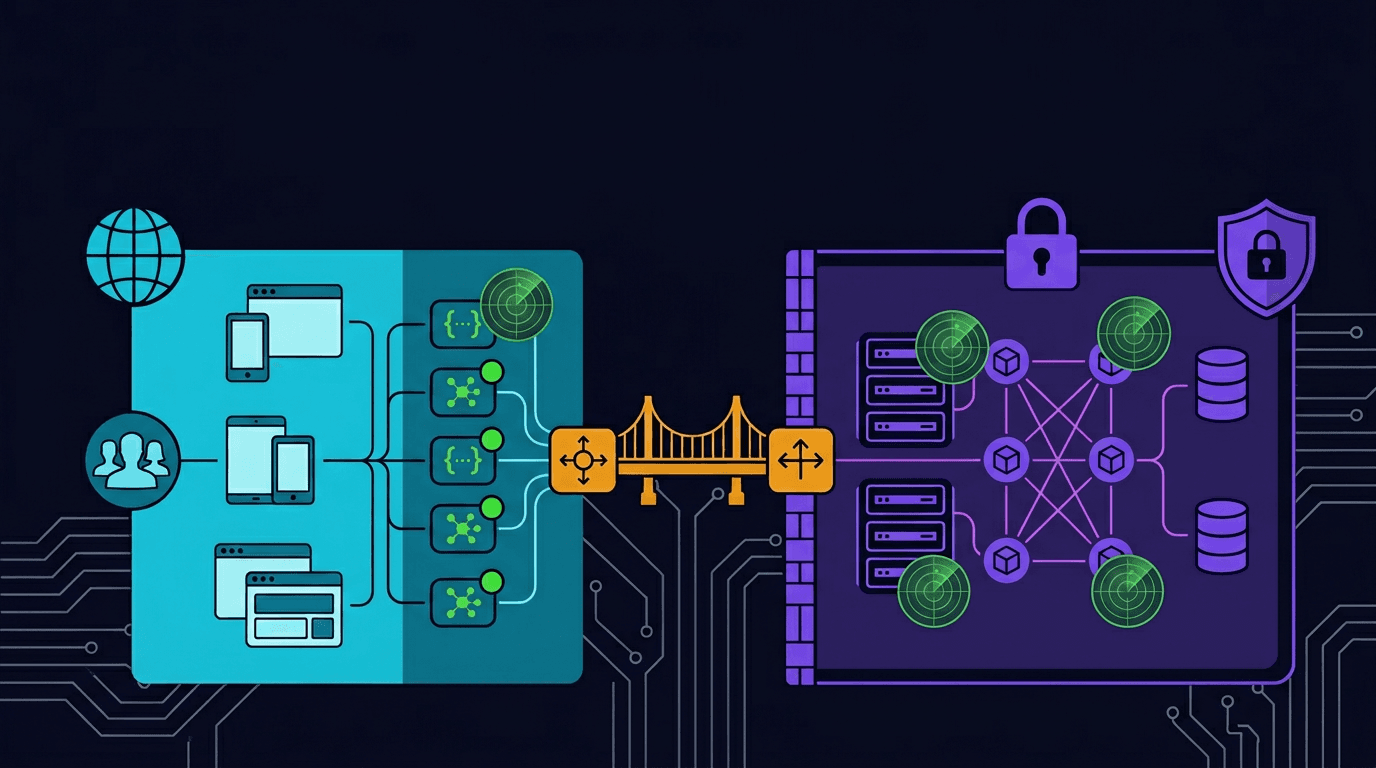
Découvrez comment élaborer une stratégie de surveillance des API qui couvre à la fois les points de terminaison publics et privés, y compris la gestion de l'authentification, les méthodes d'accès aux API internes, les SLO distincts, les considérations de sécurité et la visibilité unifiée.
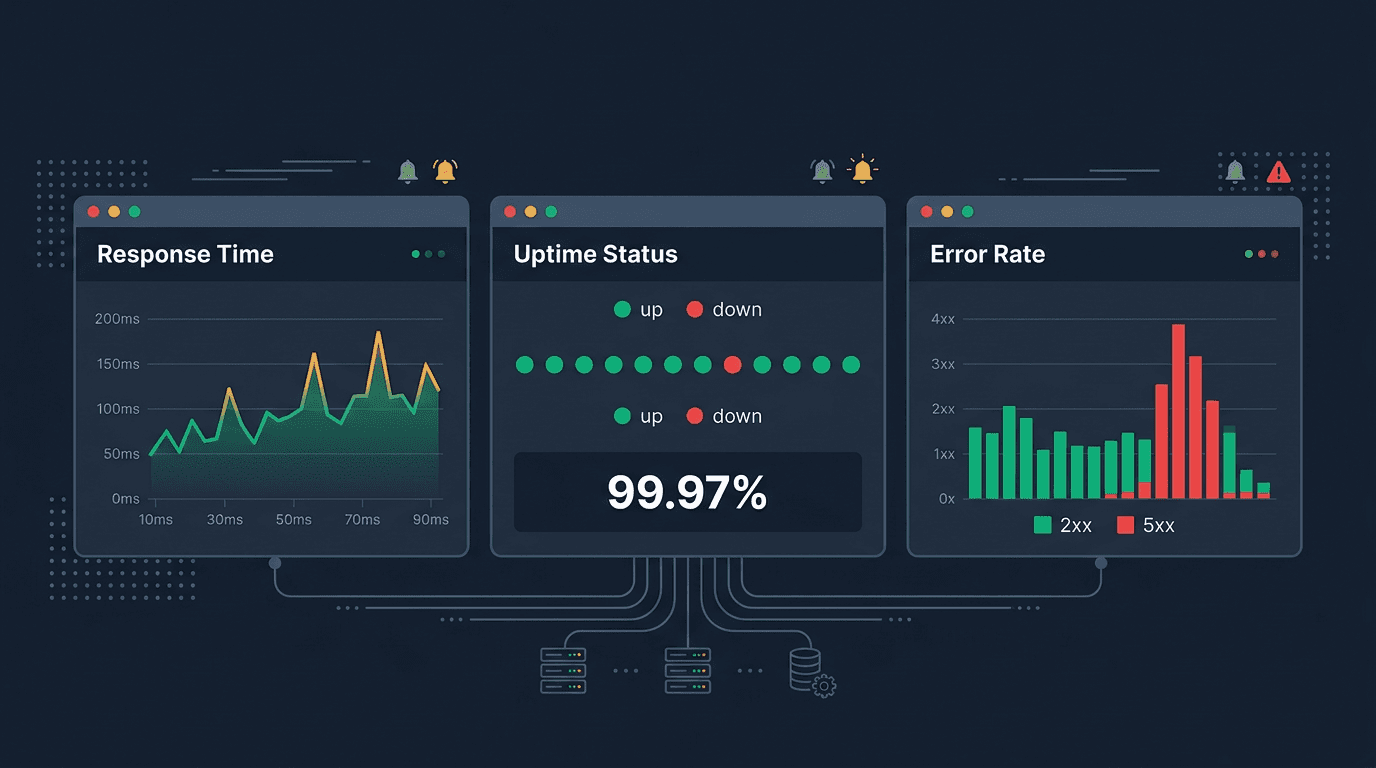
Découvrez comment surveiller le temps de réponse, la disponibilité et les taux d'erreur des API en temps réel à l'aide de contrôles synthétiques, de sondes multirégions, de tableaux de bord centiles, de classification des erreurs, de seuils d'alerte et de workflows de réponse aux incidents.
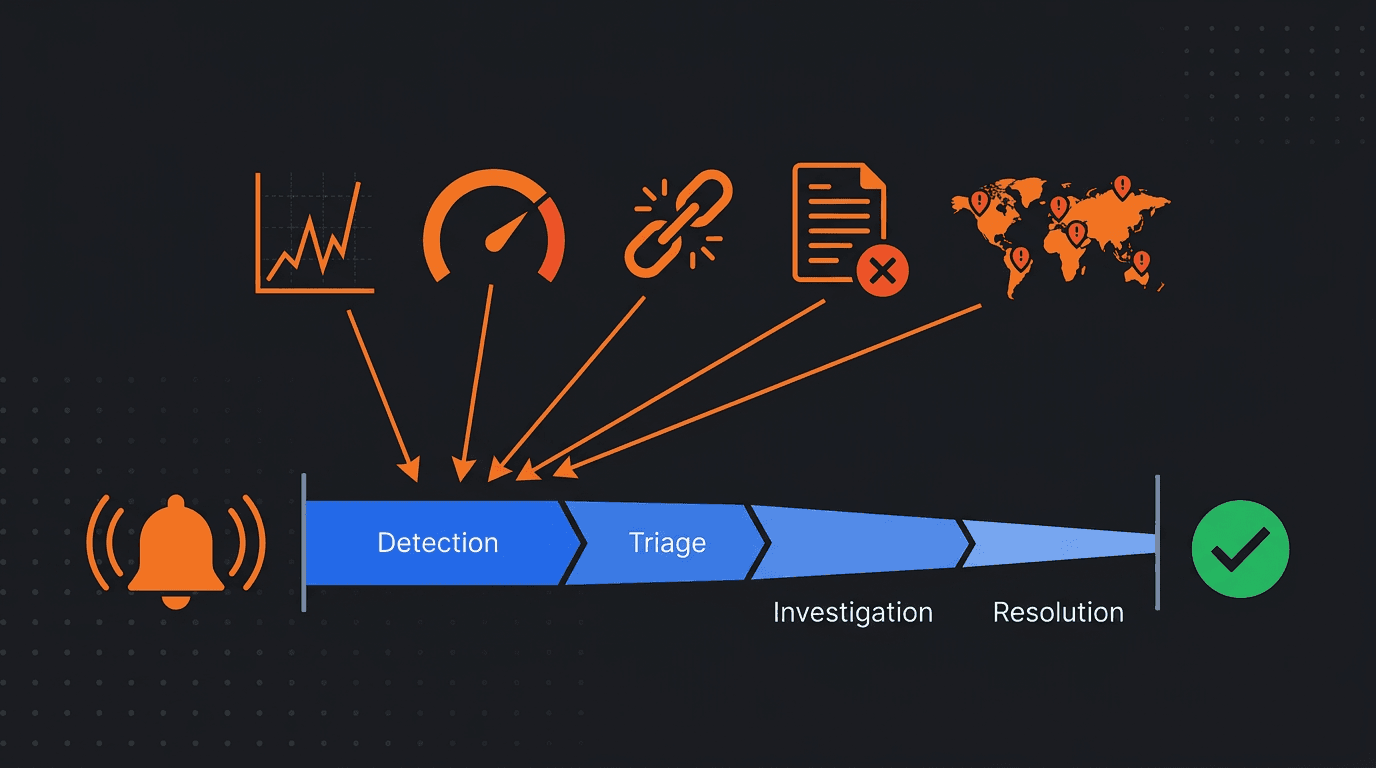
Quelles alertes de surveillance des API réduisent le plus le temps de réponse aux incidents ?
Découvrez quelles alertes de surveillance des API réduisent le plus le temps de réponse aux incidents, depuis les échecs de disponibilité multirégionaux et les pics de taux d'erreur jusqu'aux violations de percentiles de latence, aux alertes de dépendance et aux échecs de validation des réponses.
Pourquoi la surveillance des API tierces est-elle essentielle pour les produits SaaS modernes ?
Comprenez pourquoi la surveillance des API tierces est essentielle pour les produits SaaS, comment les défaillances de dépendances externes affectent vos clients et comment créer une surveillance qui protège contre les pannes de fournisseurs que vous ne pouvez pas contrôler.
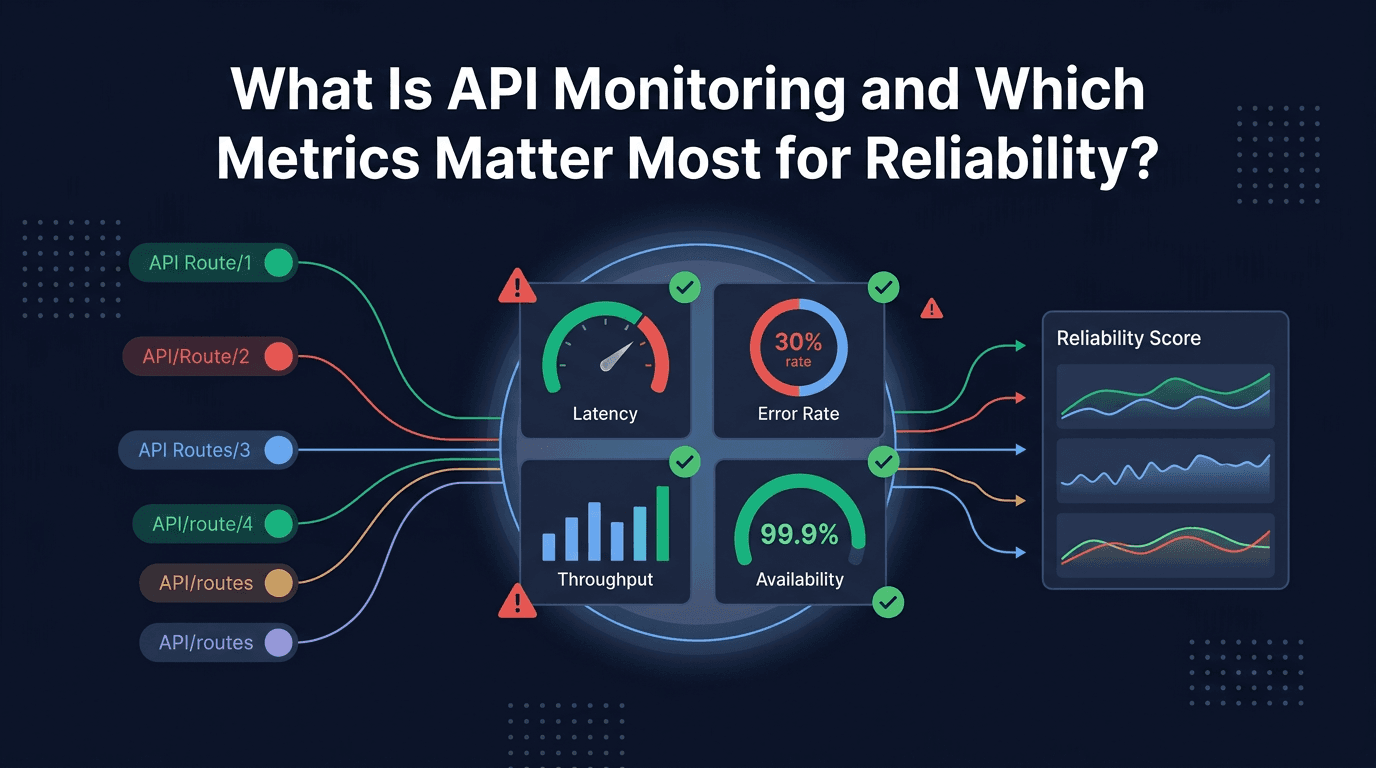
Découvrez ce qu'est la surveillance des API et quelles mesures sont les plus importantes pour la fiabilité, notamment la disponibilité, les centiles de latence, les taux d'erreur, le délai d'obtention du premier octet, le débit, les taux de délai d'attente et l'état des dépendances.
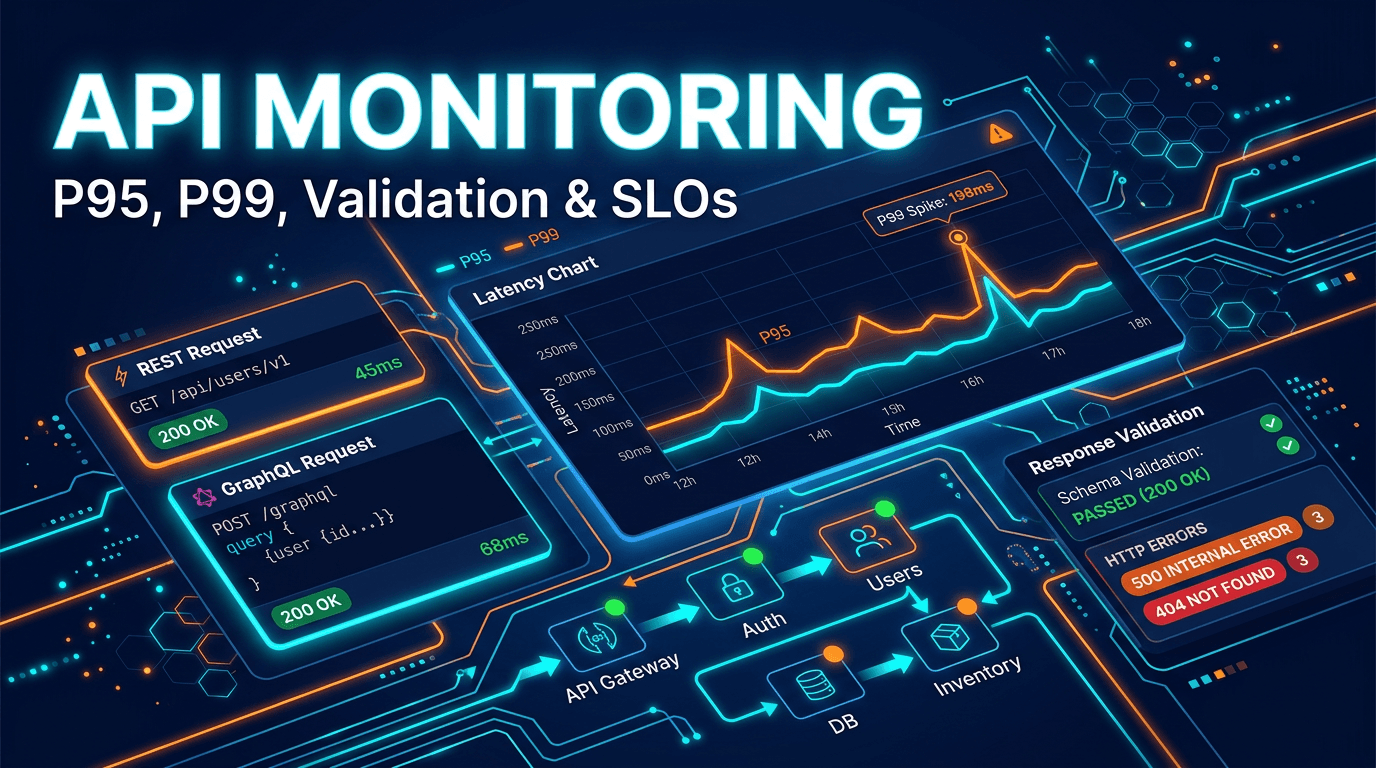
Un guide pratique 2026 sur les meilleures pratiques de surveillance des API, y compris les vérifications REST et GraphQL, la latence P95 et P99, les workflows synthétiques, la validation de schéma, les SLO et la conception d'alertes.
Un guide pratique de surveillance des API SLO pour 2026 couvrant les objectifs de niveau de service, les budgets d'erreurs, la latence P95 et P99, les alertes et comment aligner la surveillance des API sur l'impact réel des utilisateurs.
Guide de surveillance des API : disponibilité, performances et validation des réponses
Guide complet de surveillance des API : surveillez la disponibilité des points de terminaison REST et GraphQL, validez les schémas de réponse, suivez les mesures de performances et détectez les erreurs avant que les utilisateurs ne soient affectés.
Ce hub « Surveillance des API » regroupe les derniers articles UpScanX pour passer de la curiosité à la mise en œuvre sans fouiller tout l’archive. La page 1 liste jusqu’à 20 articles parmi 13 sur ce sujet.
Peu d’équipes traitent la fiabilité avec un seul contrôle. Il faut une responsabilité claire, des alertes utiles, de l’analyse de tendances et relier les signaux techniques à l’impact utilisateur. D’où l’intérêt durable des pages thématiques.
Plusieurs angles sur un même sujet permettent de comparer les approches — disponibilité, réduction du bruit d’alertes, sécurité ou montée en charge des opérations.
Les meilleurs articles insistent sur des systèmes concrets, des compromis mesurables et des habitudes reproductibles : quoi surveiller, comment alerter, éviter les interruptions et lier les choix techniques aux résultats business.
Utilisez cette page comme un mini parcours : commencez par l’article le plus proche de votre problème, puis les guides liés.