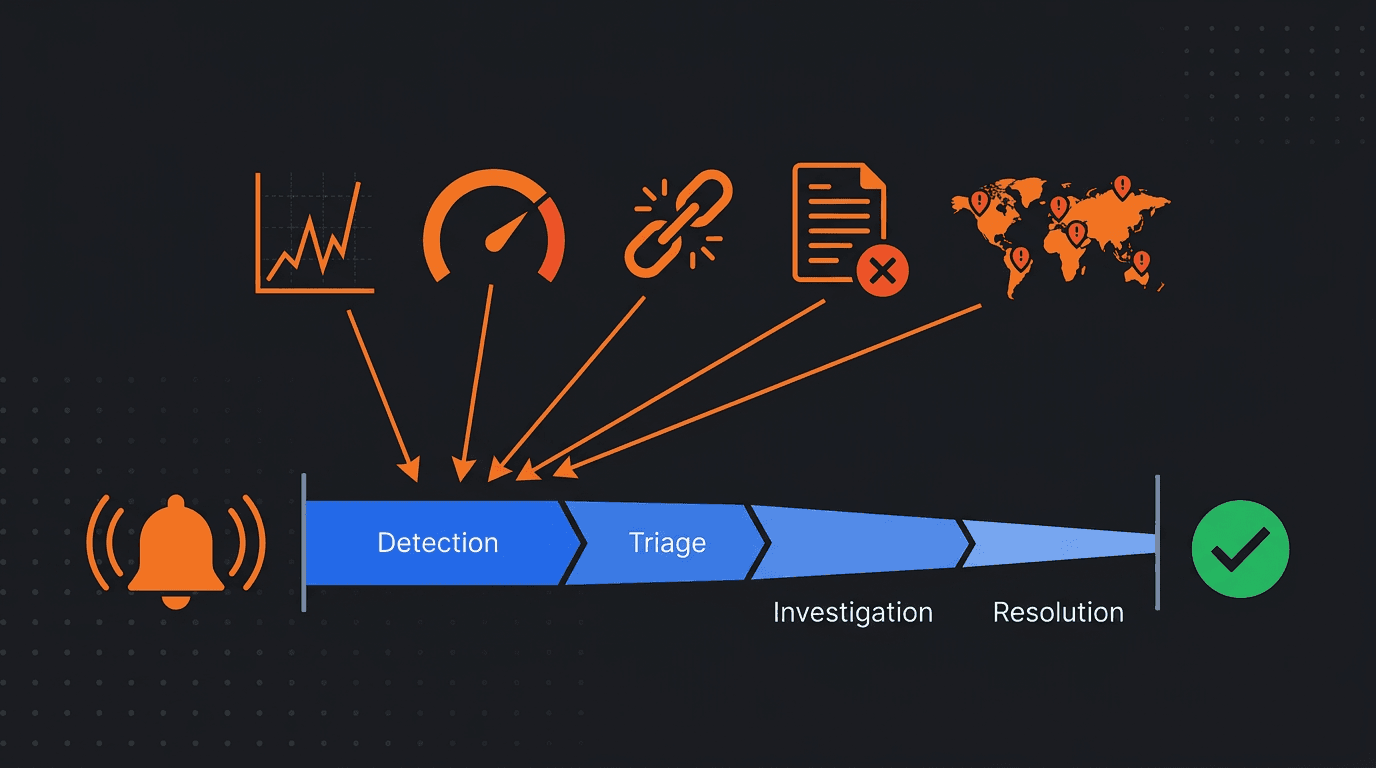
Wie können Echtzeit-Analytics-Dashboards die Incident Response verbessern?
Echtzeit-Dashboards beschleunigen jede Incident-Phase: früher erkennen, Auswirkung über Traffic und Statuscodes bewerten, schneller diagnostizieren, Erholung belegen.
Kundenlogin
Anmelden22 Blogbeiträge mit dem Tag „Incident-Response“.
Wie können Echtzeit-Analytics-Dashboards die Incident Response verbessern?
Echtzeit-Dashboards beschleunigen jede Incident-Phase: früher erkennen, Auswirkung über Traffic und Statuscodes bewerten, schneller diagnostizieren, Erholung belegen.
Wie kann Port-Monitoring stille Ausfälle erkennen, bevor HTTP-Monitoring es tut?
Port-Monitoring findet stille Ausfälle, die HTTP-Checks übersehen: tote Datenbank- und Queue-Ports, langsame TCP-Verbindungen, Replika-Ausfälle, Firewall-Änderungen.
Wie können KI-Berichte rohe Monitoring-Daten in umsetzbare Incident-Erkenntnisse verwandeln?
KI-Berichte bilden Baselines, erkennen Anomalien und bündeln Alerts zu einer Zeitleiste mit wahrscheinlicher Ursache, Auswirkung und konkreten nächsten Schritten.
Was sollte ein guter KI-Bericht nach einem Uptime- oder API-Vorfall enthalten?
Ein guter KI-Vorfallsbericht enthält Auswirkungen, Zeitleiste, korrelierte Signale, wahrscheinliche Ursache mit Konfidenz und Belegen, offene Fragen und nächste Schritte.
Warum sind KI-Berichte für Root-Cause-Analysen und Executive Summaries wichtig?
KI-Berichte machen aus denselben Monitoring-Daten belegte Root-Cause-Hypothesen für Engineers und verständliche Impact-Zusammenfassungen für das Management.
Wie hilft Ping-Monitoring, Netzwerkprobleme zu erkennen, bevor Nutzer sie bemerken?
Ping-Monitoring erkennt schleichende Latenz, Jitter, sporadischen Paketverlust und Routenänderungen früh – so beheben Teams Netzwerkprobleme vor dem Ausfall.
Welche Ping-Monitoring-Schwellenwerte sollten Sie für eine schnelle Incident-Erkennung festlegen?
Starten Sie mit 30–60 s Intervall, 2–3 Fehlern in Folge, 2-von-3-Standort-Quorum, Latenz-Alarmen bei 2x/3x Baseline und Paketverlust-Alarmen bei 2 % und 10 %.
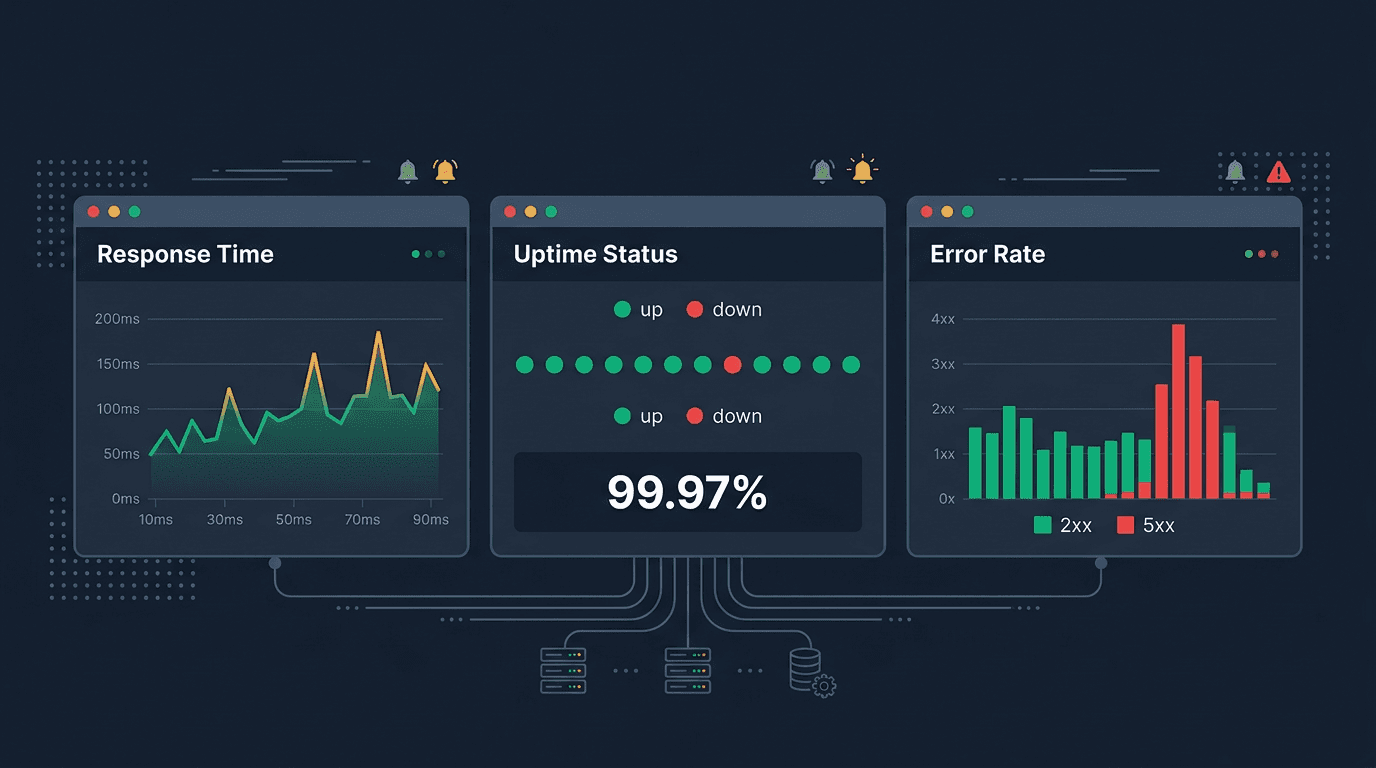
Wie überwachen Sie API-Antwortzeit, Betriebszeit und Fehlerraten in Echtzeit?
Erfahren Sie, wie Sie API-Antwortzeit, Betriebszeit und Fehlerraten in Echtzeit mithilfe synthetischer Prüfungen, multiregionaler Tests, Perzentil-Dashboards, Fehlerklassifizierung, Alarmschwellenwerten und Workflows zur Reaktion auf Vorfälle überwachen.
Welche API-Überwachungswarnungen verkürzen die Reaktionszeit bei Vorfällen am meisten?
Erfahren Sie, welche API-Überwachungswarnungen die Reaktionszeit bei Vorfällen am meisten verkürzen, von Verfügbarkeitsausfällen in mehreren Regionen und Fehlerratenspitzen bis hin zu Latenzperzentilverletzungen, Abhängigkeitswarnungen und Antwortvalidierungsfehlern.
Wie verbessern Statusseiten und Verfügbarkeitswarnungen das Kundenvertrauen?
Erfahren Sie, wie Statusseiten und Verfügbarkeitswarnungen das Vertrauen der Kunden stärken, indem sie die Transparenz erhöhen, die Kommunikation von Vorfällen beschleunigen, Unsicherheiten reduzieren und bei Ausfällen bessere Erwartungen wecken.
Warum reicht eine Verfügbarkeit von 99,9 % für moderne Websites nicht aus?
Erfahren Sie, warum eine Betriebszeit von 99,9 % für moderne Websites nicht mehr ausreicht, wie sich Ausfallzeiten auf Umsatz, SEO und Vertrauen auswirken und welche Zuverlässigkeitsziele Teams stattdessen anstreben sollten.
Wie überwachen Sie die Website-Verfügbarkeit an mehreren globalen Standorten?
Erfahren Sie, wie Sie die Website-Verfügbarkeit an mehreren globalen Standorten überwachen, warum regionale Prüfungen wichtig sind und wie Sie Fehlalarme reduzieren und gleichzeitig SEO und Benutzererfahrung schützen.
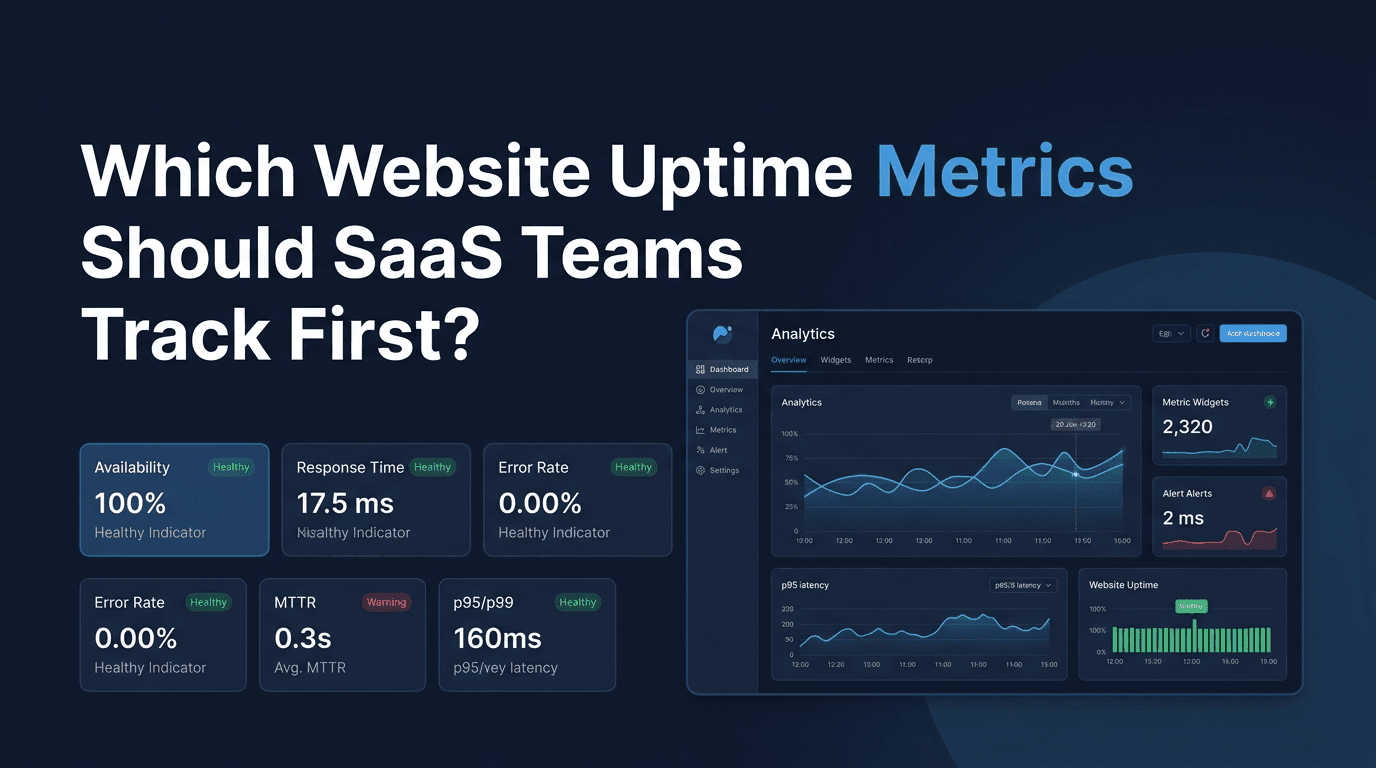
Welche Kennzahlen zur Website-Verfügbarkeit sollten SaaS-Teams zuerst verfolgen?
Erfahren Sie, welche Website-Verfügbarkeitsmetriken SaaS-Teams zuerst verfolgen sollten, einschließlich Verfügbarkeit, Latenz, Fehlerrate, MTTR und Benutzerauswirkungssignale, die die Zuverlässigkeit verbessern.
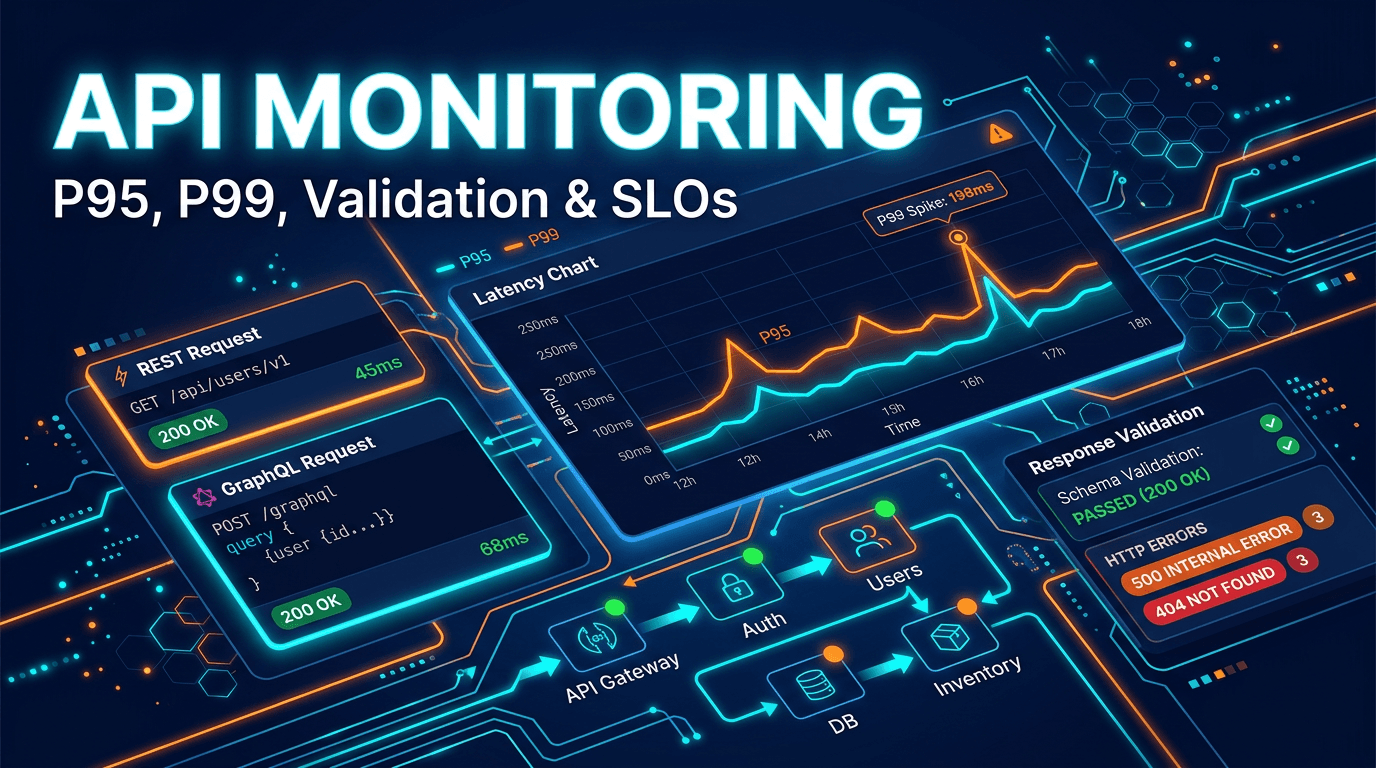
Ein praktischer API-SLO-Überwachungsleitfaden für 2026, der Service-Level-Ziele, Fehlerbudgets, P95- und P99-Latenz, Warnungen und die Ausrichtung der API-Überwachung an den tatsächlichen Auswirkungen auf den Benutzer abdeckt.
Eine praktische Checkliste zur Überwachung kritischer offener Ports im Jahr 2026, die Erreichbarkeit, unerwartete Gefährdung, TCP- und UDP-Zustand, Sicherheitsgrundlinien und Dienstbesitz abdeckt.
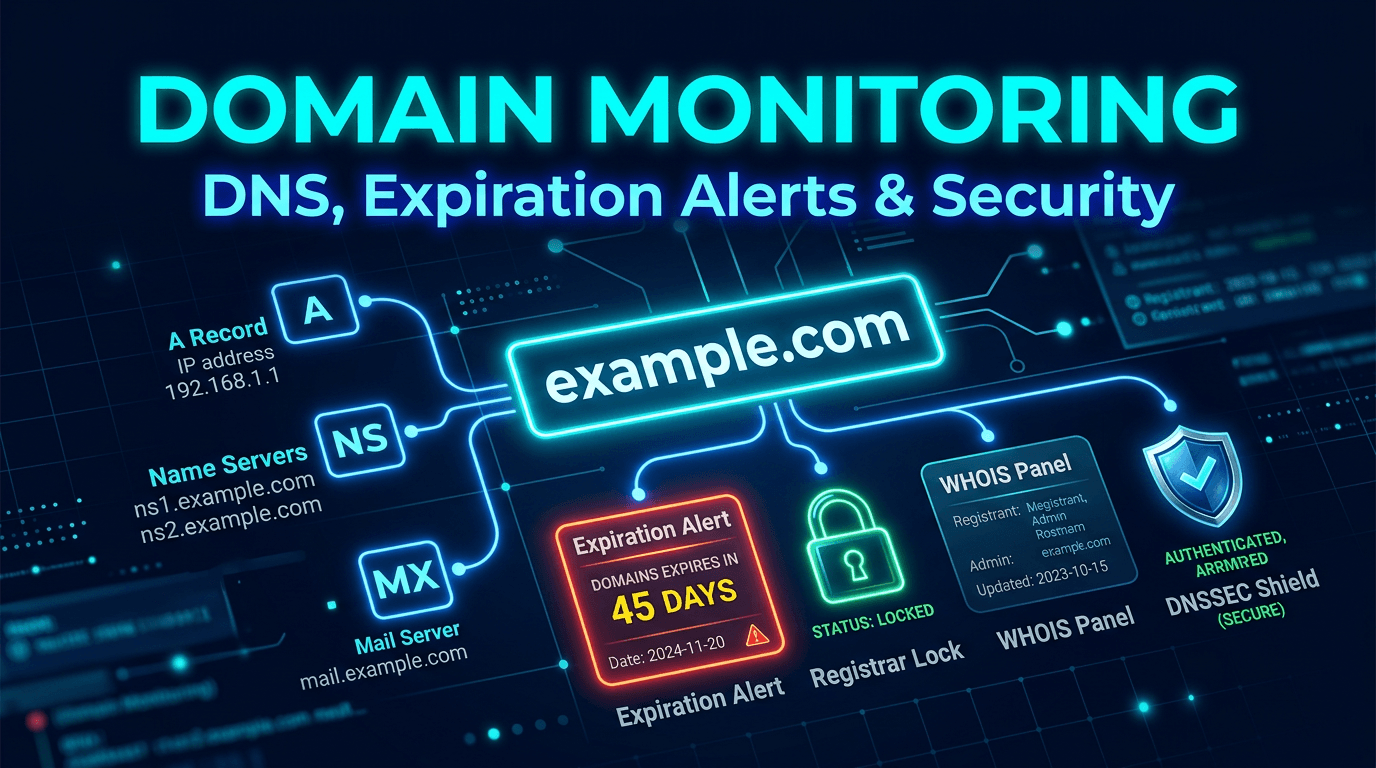
Ein vollständiger Leitfaden für 2026 zu Best Practices für die Domain-Überwachung, der die Erkennung von DNS-Änderungen, die Sicherheit des Registrators, Ablaufwarnungen, DNSSEC, E-Mail-Einträge und SEO-Schutz umfasst.
Erfahren Sie, wie KI im Jahr 2026 die Alarmmüdigkeit reduziert, indem sie Vorfälle korreliert, Ereignisse mit hoher Signalstärke priorisiert, Lärm unterdrückt und die Überwachungsabläufe für Betriebsteams verbessert.
KI-gestützte Überwachungsberichte: Anomalieerkennung und Einblicke in die Infrastruktur
Wie KI-gestützte Überwachungsberichte funktionieren – automatische Anomalieerkennung, prädiktive Analysen, Ursachenanalyse und intelligente Leistungsoptimierung für die Infrastrukturüberwachung.
Erfahren Sie, wie Sie Website-Ausfallzeiten im Jahr 2026 mit praktischen Strategien zu Überwachung, Failover, Alarmierung, Reaktion auf Vorfälle, SEO-Schutz und Infrastrukturresilienz reduzieren können.
Was ist die Überwachung der Website-Verfügbarkeit? Vollständiger Leitfaden für 2026
Erfahren Sie, was die Überwachung der Website-Verfügbarkeit ist, warum sie für Umsatz und SEO wichtig ist, Best Practices für Prüfintervalle und Benachrichtigungen und wie Sie die Überwachung von globalen Standorten aus durchführen können.
Diese Incident-Response-Übersicht bündelt die neuesten UpScanX-Artikel – vom Interesse zur Umsetzung, ohne das gesamte Archiv durchsuchen zu müssen. Seite 1 zeigt bis zu 20 von 22 Beiträgen zu diesem Thema.
Zuverlässigkeit löst kaum ein Team mit einem einzelnen Check. Es braucht klare Verantwortung, sinnvolle Alerts, Trendanalyse und die Verknüpfung technischer Signale mit Nutzerwirkung. Deshalb bleiben thematische Seiten dauerhaft nützlich.
Mehrere Blickwinkel zum selben Thema helfen, Ansätze zu vergleichen – ob Uptime, weniger Alert-Lärm, mehr Sicherheit oder skalierbare Operations.
Die stärksten Beiträge betonen pragmatische Systeme, messbare Trade-offs und wiederholbare Gewohnheiten: was überwachen, wie alarmieren, Ausfallzeiten vermeiden und wie Engineering-Entscheidungen das Geschäft beeinflussen.
Nutzen Sie die Seite als kurzen Lernpfad: zuerst der Artikel, der am Problem am nächsten ist, dann verwandte Guides.