Как дашборды аналитики в реальном времени улучшают реагирование на инциденты?
Дашборды в реальном времени ускоряют каждую фазу инцидента: раннее обнаружение, оценка влияния по трафику и кодам статуса, быстрая диагностика, проверка восстановления.
Вход для клиентов
Войти11 постов в блоге с тегом «Управление инцидентами».
Как дашборды аналитики в реальном времени улучшают реагирование на инциденты?
Дашборды в реальном времени ускоряют каждую фазу инцидента: раннее обнаружение, оценка влияния по трафику и кодам статуса, быстрая диагностика, проверка восстановления.
Что должен включать аналитический дашборд для мониторинга аптайма и инцидентов?
Хороший дашборд аптайма показывает текущий статус, аптайм против SLA, время отклика p50/p95, активные инциденты, MTTD/MTTR, коды ошибок, сроки SSL и доменов, регионы.
Какие KPI мониторинга нужны на аналитическом дашборде для руководства?
Дашборду для руководства нужны 5–8 KPI результата: доступность против SLO, бюджет ошибок, инциденты для клиентов, тренд MTTR, задержка p95 и сроки истечения.
Зачем командам единый аналитический дашборд для мониторинга инфраструктуры?
Единый дашборд объединяет данные об аптайме, SSL, доменах, сети и трафике, сокращая переключение контекста, дубли алертов и время корреляции при инцидентах.
Как ИИ-отчёты мониторинга помогают DevOps-командам снизить усталость от алертов?
ИИ-отчёты снижают усталость от алертов: объединяют связанные алерты в инциденты, выявляют «шумные» мониторы и переносят мелкие сигналы в дайджест.
Как ИИ-отчёты превращают сырые данные мониторинга в практичные выводы об инцидентах?
ИИ-отчёты нормализуют результаты проверок, строят базовые профили, выявляют аномалии и объединяют алерты в единую хронологию с вероятной причиной, влиянием и шагами.
Что такое AI-отчёты в платформах мониторинга и как они экономят время?
AI-отчёты превращают данные об аптайме, задержках, SSL, API и инцидентах в сводки с аномалиями и подсказками о первопричинах, экономя часы ручного анализа.
Что должен включать хороший AI-отчёт после инцидента с доступностью или API?
Хороший ИИ-отчёт об инциденте описывает влияние, хронологию, связанные сигналы, вероятную причину с уверенностью и доказательствами, неизвестные и шаги.
Каким сценариям мониторинга больше всего помогают отчёты, сгенерированные ИИ?
ИИ-отчёты полезнее всего при инцидентах с множеством сигналов, отчётности по SLA, медленной деградации, портфелях SSL и доменов, сторонних API и для агентств.
Почему ИИ-отчёты важны для анализа первопричин и executive summary?
ИИ-отчёты превращают одни и те же данные мониторинга в обоснованные гипотезы о первопричинах для инженеров и понятные сводки о последствиях для руководства.
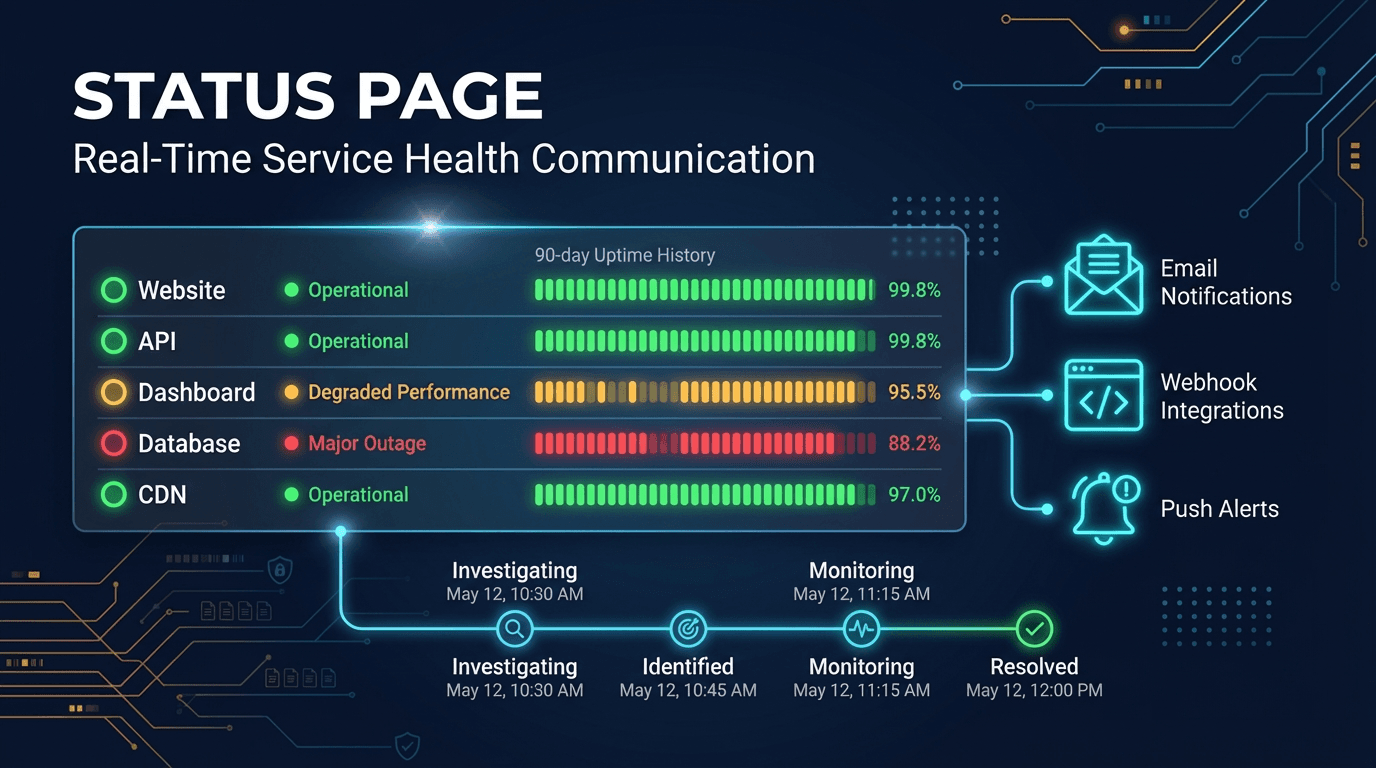
Полное руководство по общедоступным страницам состояния — фирменные информационные панели состояния сервисов с отображением состояния компонентов в реальном времени, автоматическими обновлениями инцидентов, 90-дневной историей бесперебойной работы и уведомлениями подписчиков.
Раздел «Управление инцидентами» собирает свежие статьи UpScanX: от интереса к внедрению без просмотра всего архива. Страница 1 показывает до 20 из 11 материалов по теме.
Надёжность редко решается одной проверкой. Нужны ответственность, полезные алерты, анализ трендов и связь сигналов с влиянием на пользователей. Поэтому тематические страницы остаются ценными.
Разные углы одной темы помогают сравнивать подходы: доступность, шум алертов, безопасность или масштабирование операций.
Сильные материалы опираются на практику, измеримые компромиссы и привычки: что мониторить, как алертить, как снижать простои и как инженерные решения влияют на бизнес.
Используйте страницу как короткий маршрут: сначала статья ближе всего к вашей задаче, затем связанные гайды.