Was sollte ein Analytics-Dashboard für Uptime- und Incident-Monitoring enthalten?
Ein gutes Uptime-Dashboard zeigt aktuellen Status, Uptime vs. SLA, p50/p95-Antwortzeiten, aktive Incidents, MTTD/MTTR, Fehlercodes, SSL-/Domain-Ablauf und Regionen.
Kundenlogin
Anmelden9 Blogbeiträge mit dem Tag „Uptime-Überwachung“.
Was sollte ein Analytics-Dashboard für Uptime- und Incident-Monitoring enthalten?
Ein gutes Uptime-Dashboard zeigt aktuellen Status, Uptime vs. SLA, p50/p95-Antwortzeiten, aktive Incidents, MTTD/MTTR, Fehlercodes, SSL-/Domain-Ablauf und Regionen.
Welche Monitoring-KPIs gehören auf ein Executive-Analytics-Dashboard?
Ein Executive-Dashboard braucht 5-8 Ergebnis-KPIs: Verfügbarkeit vs. SLO, verbleibendes Error Budget, kundenwirksame Incidents, MTTR-Trend, p95-Latenz und Ablaufrisiken.
Wie kann Port-Monitoring stille Ausfälle erkennen, bevor HTTP-Monitoring es tut?
Port-Monitoring findet stille Ausfälle, die HTTP-Checks übersehen: tote Datenbank- und Queue-Ports, langsame TCP-Verbindungen, Replika-Ausfälle, Firewall-Änderungen.
Was ist Port-Monitoring und warum ist es für die Netzwerkzuverlässigkeit wichtig?
Port-Monitoring prüft, ob ein Dienst Verbindungen auf einem bestimmten TCP- oder UDP-Port annimmt. Erfahren Sie, was es erkennt, das Ping und HTTP-Checks übersehen.
Warum ist Port-Monitoring für Sicherheit, Verfügbarkeit und Compliance wichtig?
Port-Monitoring erkennt exponierte Dienste, stille Ausfälle und Konfigurationsdrift frühzeitig und liefert eine lückenlose Historie als Nachweis für Sicherheitsaudits.
Was sind KI-Berichte in Monitoring-Plattformen und wie sparen sie Zeit?
KI-Berichte verdichten Uptime-, Latenz-, SSL-, API- und Incident-Daten zu Zusammenfassungen mit Anomalien und Ursachenhinweisen und sparen Stunden an Auswertung.
Was sollte ein guter KI-Bericht nach einem Uptime- oder API-Vorfall enthalten?
Ein guter KI-Vorfallsbericht enthält Auswirkungen, Zeitleiste, korrelierte Signale, wahrscheinliche Ursache mit Konfidenz und Belegen, offene Fragen und nächste Schritte.
Welche Monitoring-Anwendungsfälle profitieren am meisten von KI-generierten Berichten?
KI-Berichte lohnen sich bei Vorfällen mit vielen Signalen, SLA-Reporting, schleichender Verschlechterung, SSL- und Domain-Portfolios, Drittanbieter-APIs und Agenturen.
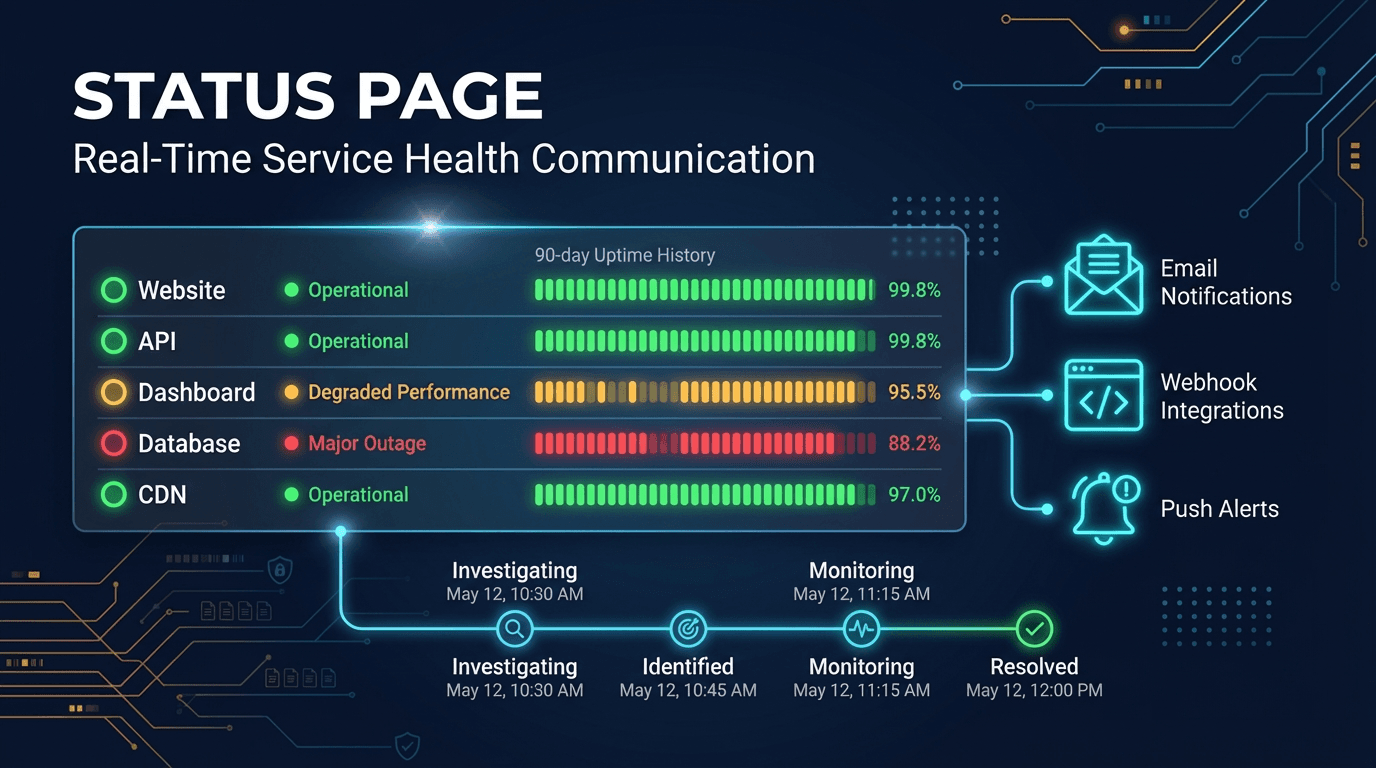
Statusseiten: Echtzeit-Service-Health-Kommunikation für Ihre Benutzer
Vollständiger Leitfaden zu öffentlichen Statusseiten – gebrandete Service-Zustands-Dashboards mit Echtzeit-Komponentenstatus, automatisierten Vorfallaktualisierungen, 90-Tage-Verfügbarkeitsverlauf und Abonnentenbenachrichtigungen.
Diese Uptime-Überwachung-Übersicht bündelt die neuesten UpScanX-Artikel – vom Interesse zur Umsetzung, ohne das gesamte Archiv durchsuchen zu müssen. Seite 1 zeigt bis zu 20 von 9 Beiträgen zu diesem Thema.
Zuverlässigkeit löst kaum ein Team mit einem einzelnen Check. Es braucht klare Verantwortung, sinnvolle Alerts, Trendanalyse und die Verknüpfung technischer Signale mit Nutzerwirkung. Deshalb bleiben thematische Seiten dauerhaft nützlich.
Mehrere Blickwinkel zum selben Thema helfen, Ansätze zu vergleichen – ob Uptime, weniger Alert-Lärm, mehr Sicherheit oder skalierbare Operations.
Die stärksten Beiträge betonen pragmatische Systeme, messbare Trade-offs und wiederholbare Gewohnheiten: was überwachen, wie alarmieren, Ausfallzeiten vermeiden und wie Engineering-Entscheidungen das Geschäft beeinflussen.
Nutzen Sie die Seite als kurzen Lernpfad: zuerst der Artikel, der am Problem am nächsten ist, dann verwandte Guides.