Wie kann Port-Monitoring stille Ausfälle erkennen, bevor HTTP-Monitoring es tut?
Port-Monitoring findet stille Ausfälle, die HTTP-Checks übersehen: tote Datenbank- und Queue-Ports, langsame TCP-Verbindungen, Replika-Ausfälle, Firewall-Änderungen.
Kundenlogin
Anmelden17 Blogbeiträge mit dem Tag „Netzwerküberwachung“.
Wie kann Port-Monitoring stille Ausfälle erkennen, bevor HTTP-Monitoring es tut?
Port-Monitoring findet stille Ausfälle, die HTTP-Checks übersehen: tote Datenbank- und Queue-Ports, langsame TCP-Verbindungen, Replika-Ausfälle, Firewall-Änderungen.
Wie überwacht man offene Ports für Webserver, Datenbanken und Mail-Dienste?
Überwachen Sie Web-, Datenbank- und Mail-Ports über die Protokollantwort statt nur den TCP-Handshake – und alarmieren Sie, wenn Datenbanken öffentlich erreichbar sind.
Was sind die besten Port-Monitoring-Tools für DevOps- und IT-Teams?
Die besten Port-Monitoring-Tools verbinden TCP/UDP-Checks mit Protokollvalidierung und Änderungserkennung. Scanner, Self-Hosted und SaaS im Vergleich.
Was ist Port-Monitoring und warum ist es für die Netzwerkzuverlässigkeit wichtig?
Port-Monitoring prüft, ob ein Dienst Verbindungen auf einem bestimmten TCP- oder UDP-Port annimmt. Erfahren Sie, was es erkennt, das Ping und HTTP-Checks übersehen.
Welche Ports sollten Sie in der Produktionsinfrastruktur zuerst überwachen?
Zuerst öffentliche Einstiegspunkte (443, 80, API, DNS, SMTP), dann interne Datenbanken, Caches und Queues, dann Management-Ports, die nie öffentlich sein sollten.
Warum ist Port-Monitoring für Sicherheit, Verfügbarkeit und Compliance wichtig?
Port-Monitoring erkennt exponierte Dienste, stille Ausfälle und Konfigurationsdrift frühzeitig und liefert eine lückenlose Historie als Nachweis für Sicherheitsaudits.
Wie überwacht man Paketverlust und Latenz über globale Regionen hinweg?
Paketverlust und Latenz global überwachen: Messpunkte nahe den Nutzern, Baselines pro Region, p95 und Jitter statt Durchschnitt und Alarme per Quorum.
Wie hilft Ping-Monitoring, Netzwerkprobleme zu erkennen, bevor Nutzer sie bemerken?
Ping-Monitoring erkennt schleichende Latenz, Jitter, sporadischen Paketverlust und Routenänderungen früh – so beheben Teams Netzwerkprobleme vor dem Ausfall.
Was sind die besten Ping-Monitoring-Tools für Server, Router und Websites?
Gutes Ping-Monitoring kombiniert einen externen Multi-Standort-Monitor für Websites mit einem internen SNMP-Tool für Router. Die Tool-Typen im Vergleich.
Was ist Ping-Monitoring und wann sollten Sie es statt HTTP-Checks einsetzen?
Ping-Monitoring prüft die Erreichbarkeit eines Hosts auf Netzwerkebene. Wann ICMP-, TCP- oder UDP-Ping HTTP-Checks überlegen ist und warum beides zusammen hilft.
Welche Ping-Monitoring-Schwellenwerte sollten Sie für eine schnelle Incident-Erkennung festlegen?
Starten Sie mit 30–60 s Intervall, 2–3 Fehlern in Folge, 2-von-3-Standort-Quorum, Latenz-Alarmen bei 2x/3x Baseline und Paketverlust-Alarmen bei 2 % und 10 %.
Warum ist Ping-Monitoring in Cloud- und Kubernetes-Umgebungen immer noch wichtig?
Cloud und Kubernetes verhindern keine Netzwerkausfälle. Ping- und TCP-Checks finden Fehler bei Security Groups, NAT, Peering, DNS und Regionen, die Probes übersehen.
Eine praktische Checkliste zur Überwachung kritischer offener Ports im Jahr 2026, die Erreichbarkeit, unerwartete Gefährdung, TCP- und UDP-Zustand, Sicherheitsgrundlinien und Dienstbesitz abdeckt.
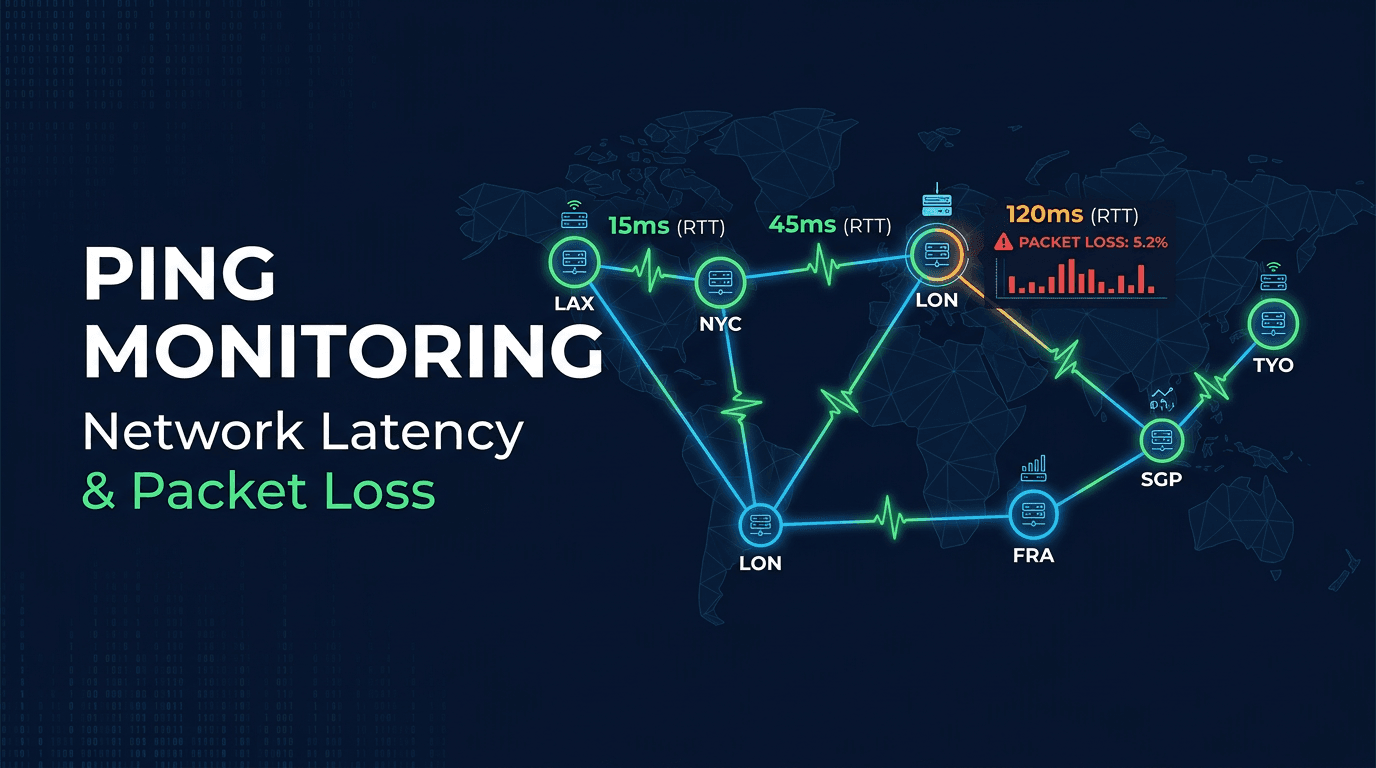
Leitfaden zur Ping-Überwachung: Latenz, Paketverlust und Netzwerkerreichbarkeit
Erfahren Sie, wie die Ping-Überwachung funktioniert – messen Sie die Netzwerklatenz, erkennen Sie Paketverluste, verfolgen Sie Jitter und überwachen Sie die Servererreichbarkeit von mehreren globalen Standorten aus mit ICMP und TCP-Ping.
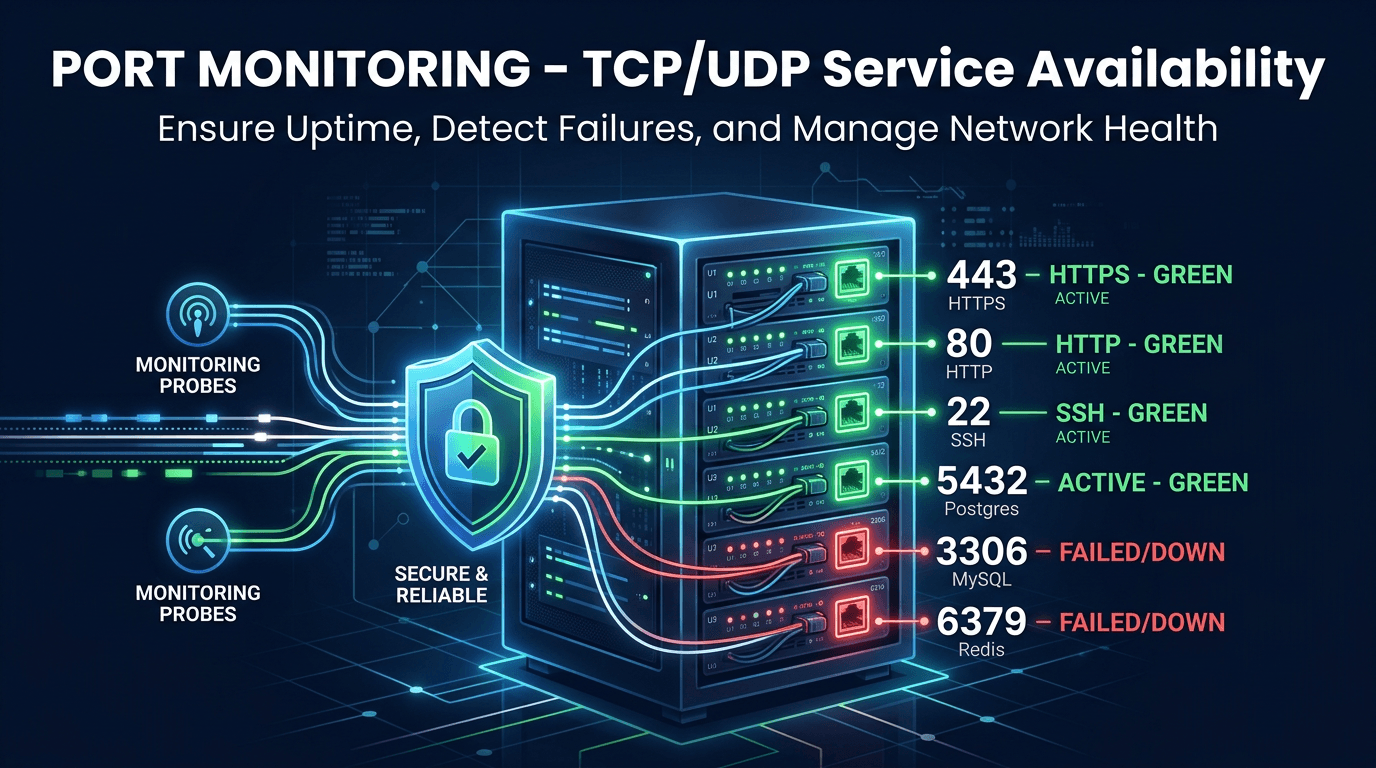
Leitfaden zur Portüberwachung: Überwachung der TCP/UDP-Dienstverfügbarkeit
Vollständiger Leitfaden zur Portüberwachung – Überwachen Sie TCP- und UDP-Ports, erkennen Sie Dienstausfälle, validieren Sie die Verfügbarkeit von Datenbanken und Anwendungsservern und verbessern Sie die Infrastruktursicherheit.
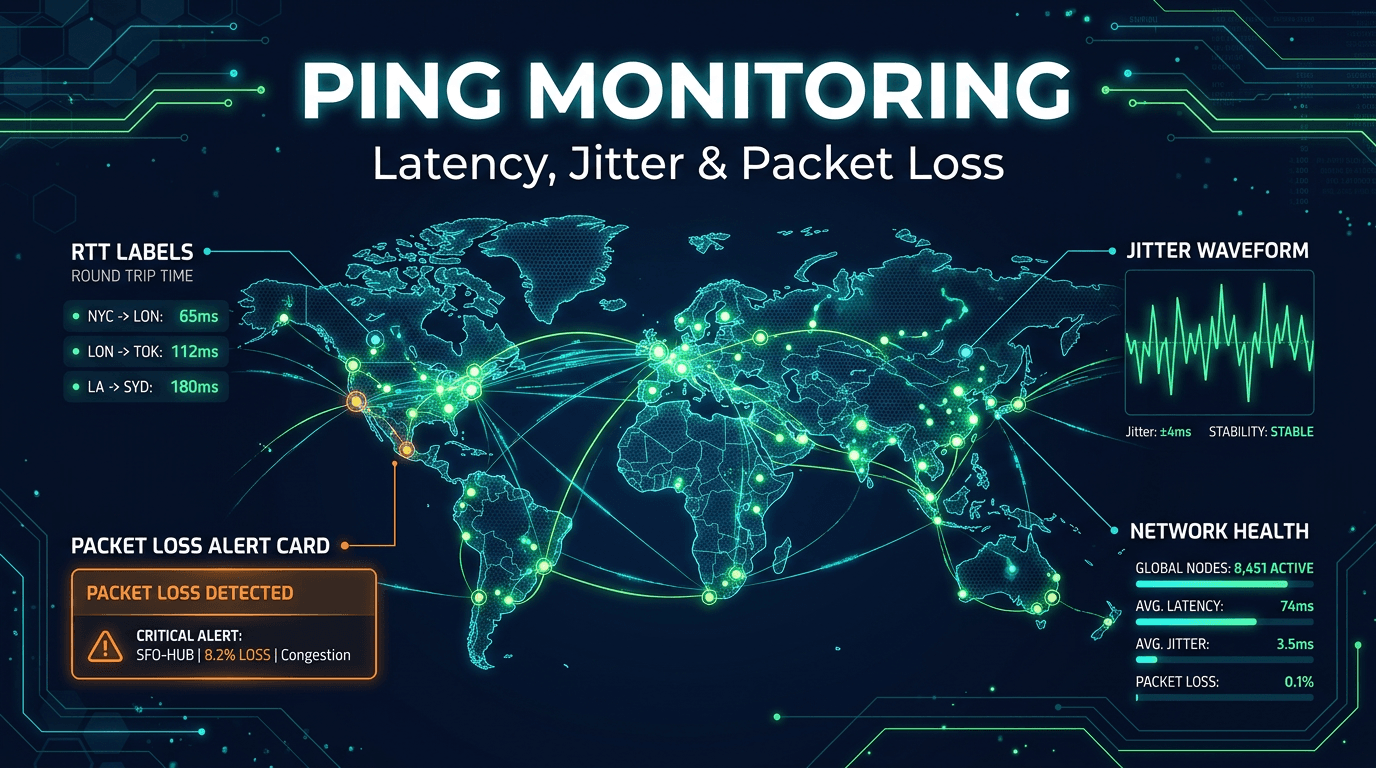
Ein praktischer Leitfaden zur Netzwerklatenzüberwachung im Jahr 2026, der sich mit RTT, Jitter, Paketverlust, regionaler Analyse, Alarmschwellenwerten und der frühzeitigen Erkennung langsamer Pfade befasst.
Best Practices für die Ping-Überwachung für 2026: Latenz, Jitter und Paketverlust erklärt
Erfahren Sie mehr über die besten Ping-Überwachungspraktiken für 2026, einschließlich der Verfolgung von Latenz, Jitter, Paketverlust, Erreichbarkeit mehrerer Regionen und frühzeitiger Netzwerkverschlechterung.
Diese Netzwerküberwachung-Übersicht bündelt die neuesten UpScanX-Artikel – vom Interesse zur Umsetzung, ohne das gesamte Archiv durchsuchen zu müssen. Seite 1 zeigt bis zu 20 von 17 Beiträgen zu diesem Thema.
Zuverlässigkeit löst kaum ein Team mit einem einzelnen Check. Es braucht klare Verantwortung, sinnvolle Alerts, Trendanalyse und die Verknüpfung technischer Signale mit Nutzerwirkung. Deshalb bleiben thematische Seiten dauerhaft nützlich.
Mehrere Blickwinkel zum selben Thema helfen, Ansätze zu vergleichen – ob Uptime, weniger Alert-Lärm, mehr Sicherheit oder skalierbare Operations.
Die stärksten Beiträge betonen pragmatische Systeme, messbare Trade-offs und wiederholbare Gewohnheiten: was überwachen, wie alarmieren, Ausfallzeiten vermeiden und wie Engineering-Entscheidungen das Geschäft beeinflussen.
Nutzen Sie die Seite als kurzen Lernpfad: zuerst der Artikel, der am Problem am nächsten ist, dann verwandte Guides.