Wie baut man ein Analytics-Dashboard für Website-, API- und SSL-Monitoring?
Monitoring-Dashboard in sieben Schritten: Seiten, APIs und Zertifikate erfassen, SLOs festlegen, Checks vereinheitlichen, nach Ebenen aufbauen, Alerts setzen, prüfen.
Kundenlogin
Anmelden13 Blogbeiträge mit dem Tag „API-Überwachung“.
Wie baut man ein Analytics-Dashboard für Website-, API- und SSL-Monitoring?
Monitoring-Dashboard in sieben Schritten: Seiten, APIs und Zertifikate erfassen, SLOs festlegen, Checks vereinheitlichen, nach Ebenen aufbauen, Alerts setzen, prüfen.
Was sollte ein guter KI-Bericht nach einem Uptime- oder API-Vorfall enthalten?
Ein guter KI-Vorfallsbericht enthält Auswirkungen, Zeitleiste, korrelierte Signale, wahrscheinliche Ursache mit Konfidenz und Belegen, offene Fragen und nächste Schritte.
Wie wirken sich API-Fehler auf das Kundenerlebnis, den Umsatz und die Kundenbindung aus?
API-Ausfälle und Latenzspitzen sind die stillen Killer moderner SaaS-Unternehmen. Erfahren Sie, wie API-Fehler das Kundenerlebnis beeinträchtigen, zu Umsatzverlusten durch unfreiwillige Kündigungen führen und die Kundenbindung zerstören.
Was sind die besten API-Überwachungstools für Startups und Unternehmensteams?
Entdecken Sie die besten API-Überwachungstools für Startups und Unternehmensteams im Jahr 2026. Vergleichen Sie Datadog, Checkly, Moesif, Better Stack und Treblle, um die perfekte Observability-Lösung für Ihren Stack zu finden.
So erstellen Sie eine multiregionale Überwachungsstrategie für die SaaS-Zuverlässigkeit
Erfahren Sie, wie SaaS-Teams eine Überwachungsstrategie für mehrere Regionen entwickeln können, die regionale Ausfälle, API-Verschlechterungen, Latenzspitzen und benutzerbeeinflussende Zuverlässigkeitsprobleme schneller erkennt.
Wie können Sie eine API-Überwachungsstrategie für öffentliche und private Endpunkte entwickeln?
Erfahren Sie, wie Sie eine API-Überwachungsstrategie erstellen, die sowohl öffentliche als auch private Endpunkte abdeckt, einschließlich Authentifizierungsbehandlung, Zugriffsmethoden für interne APIs, eindeutige SLOs, Sicherheitsüberlegungen und einheitliche Sichtbarkeit.
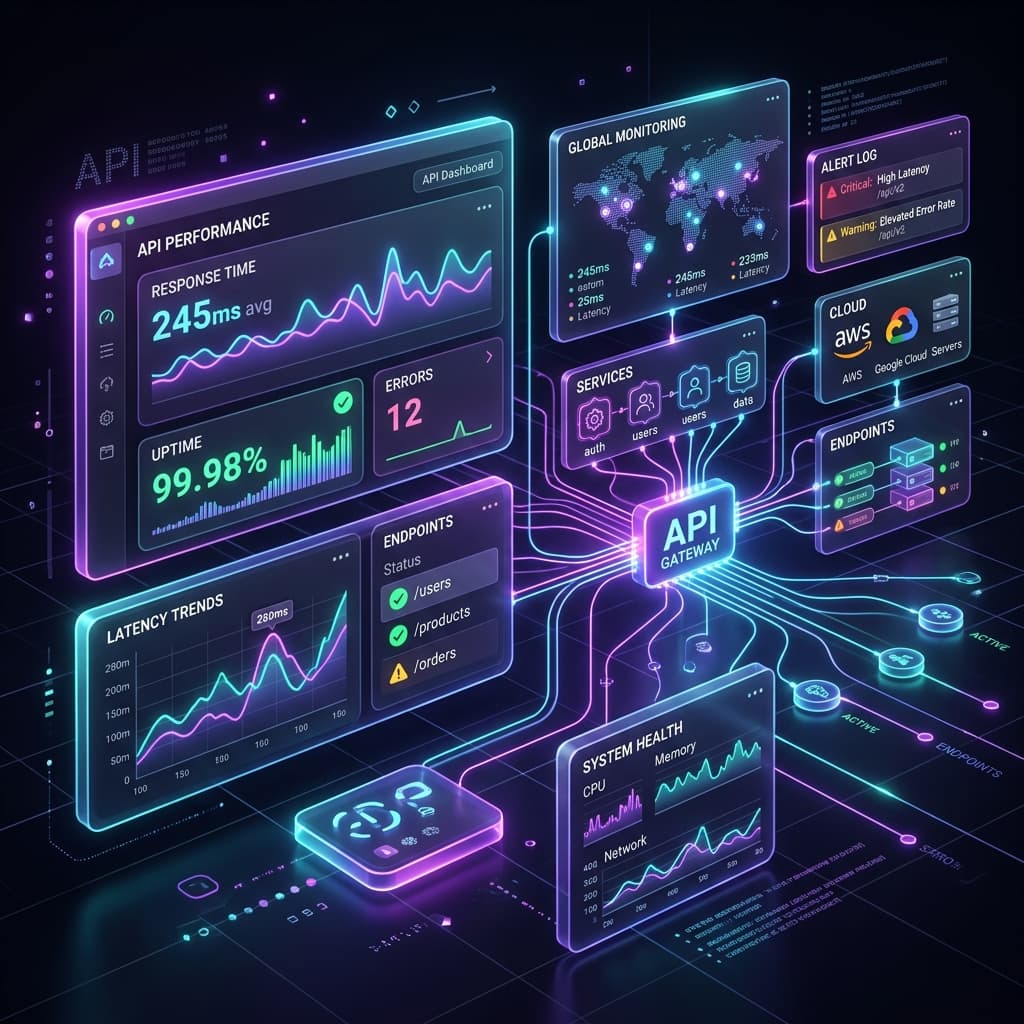
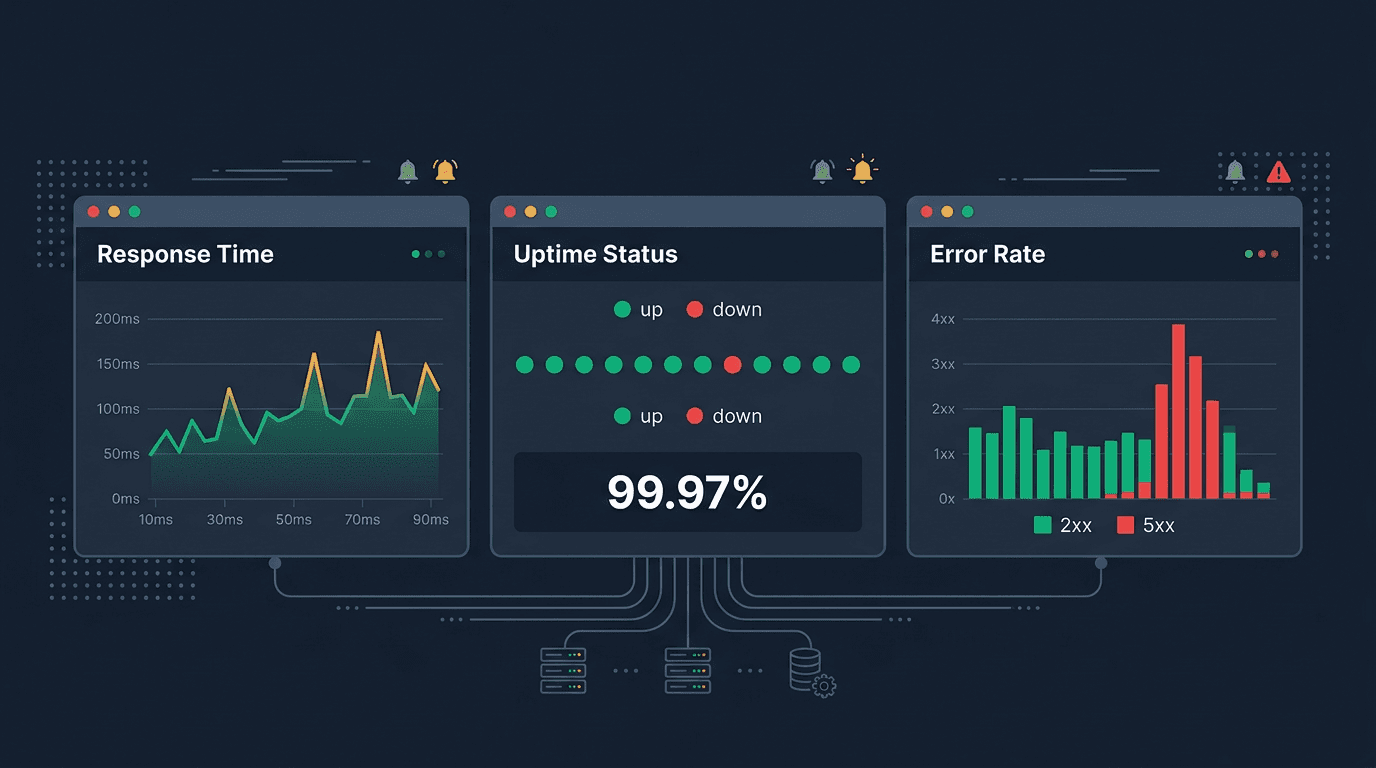
Wie überwachen Sie API-Antwortzeit, Betriebszeit und Fehlerraten in Echtzeit?
Erfahren Sie, wie Sie API-Antwortzeit, Betriebszeit und Fehlerraten in Echtzeit mithilfe synthetischer Prüfungen, multiregionaler Tests, Perzentil-Dashboards, Fehlerklassifizierung, Alarmschwellenwerten und Workflows zur Reaktion auf Vorfälle überwachen.
Welche API-Überwachungswarnungen verkürzen die Reaktionszeit bei Vorfällen am meisten?
Erfahren Sie, welche API-Überwachungswarnungen die Reaktionszeit bei Vorfällen am meisten verkürzen, von Verfügbarkeitsausfällen in mehreren Regionen und Fehlerratenspitzen bis hin zu Latenzperzentilverletzungen, Abhängigkeitswarnungen und Antwortvalidierungsfehlern.
Warum ist die API-Überwachung durch Drittanbieter für moderne SaaS-Produkte unerlässlich?
Verstehen Sie, warum die API-Überwachung von Drittanbietern für SaaS-Produkte unerlässlich ist, wie sich externe Abhängigkeitsfehler auf Ihre Kunden auswirken und wie Sie eine Überwachung aufbauen können, die vor Anbieterausfällen schützt, die Sie nicht kontrollieren können.
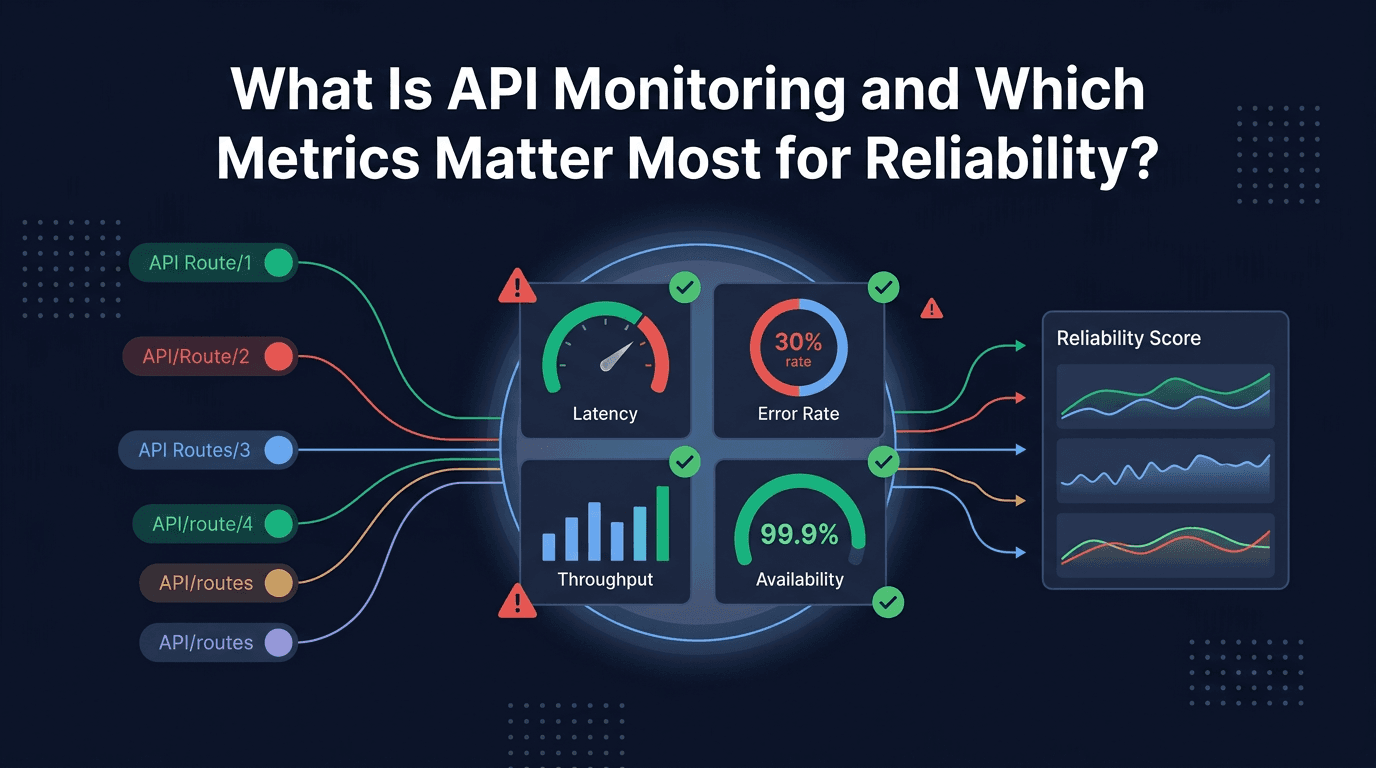
Was ist API-Überwachung und welche Metriken sind für die Zuverlässigkeit am wichtigsten?
Erfahren Sie, was API-Überwachung ist und welche Metriken für die Zuverlässigkeit am wichtigsten sind, einschließlich Verfügbarkeit, Latenzperzentile, Fehlerraten, Zeit bis zum ersten Byte, Durchsatz, Timeout-Raten und Abhängigkeitszustand.
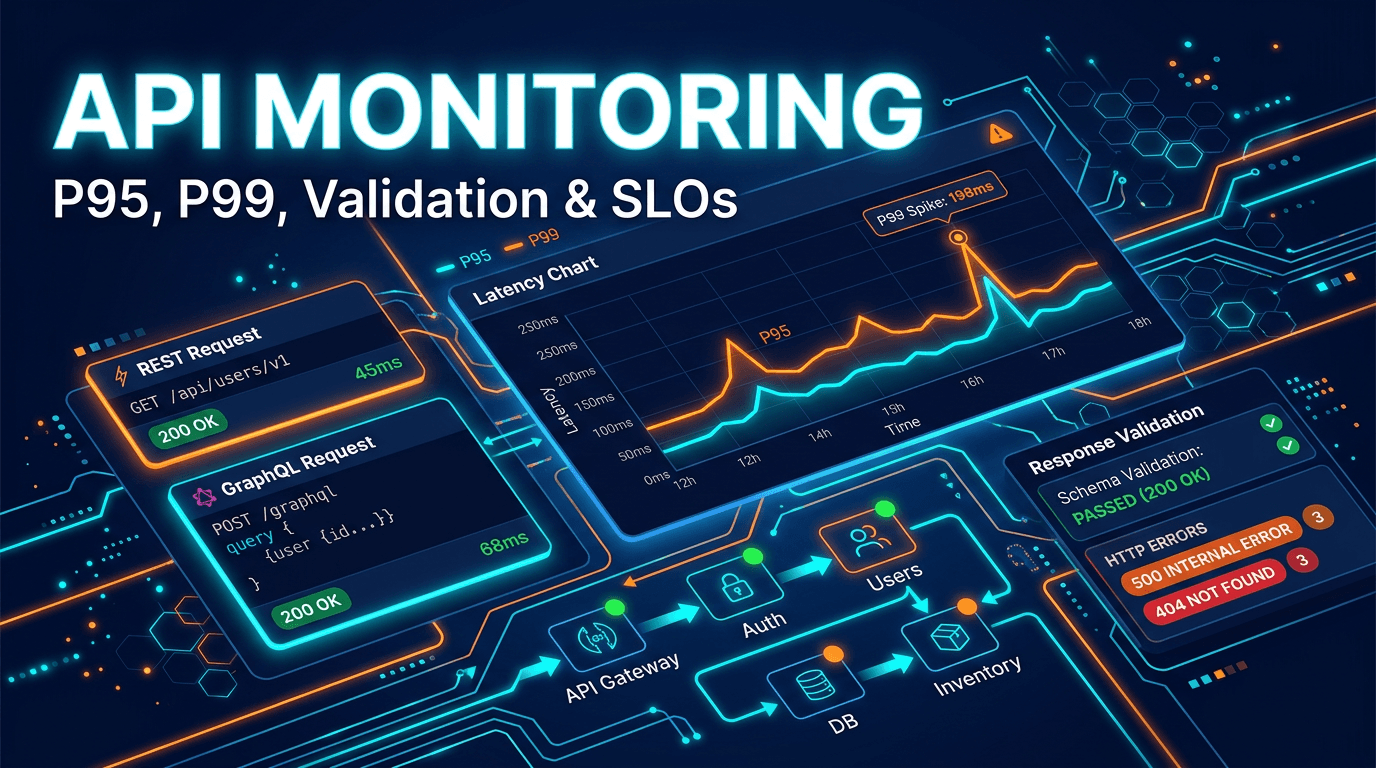
Ein praktischer Leitfaden für 2026 zu Best Practices für die API-Überwachung, einschließlich REST- und GraphQL-Prüfungen, P95- und P99-Latenz, synthetischen Workflows, Schemavalidierung, SLOs und Alarmdesign.
Ein praktischer API-SLO-Überwachungsleitfaden für 2026, der Service-Level-Ziele, Fehlerbudgets, P95- und P99-Latenz, Warnungen und die Ausrichtung der API-Überwachung an den tatsächlichen Auswirkungen auf den Benutzer abdeckt.
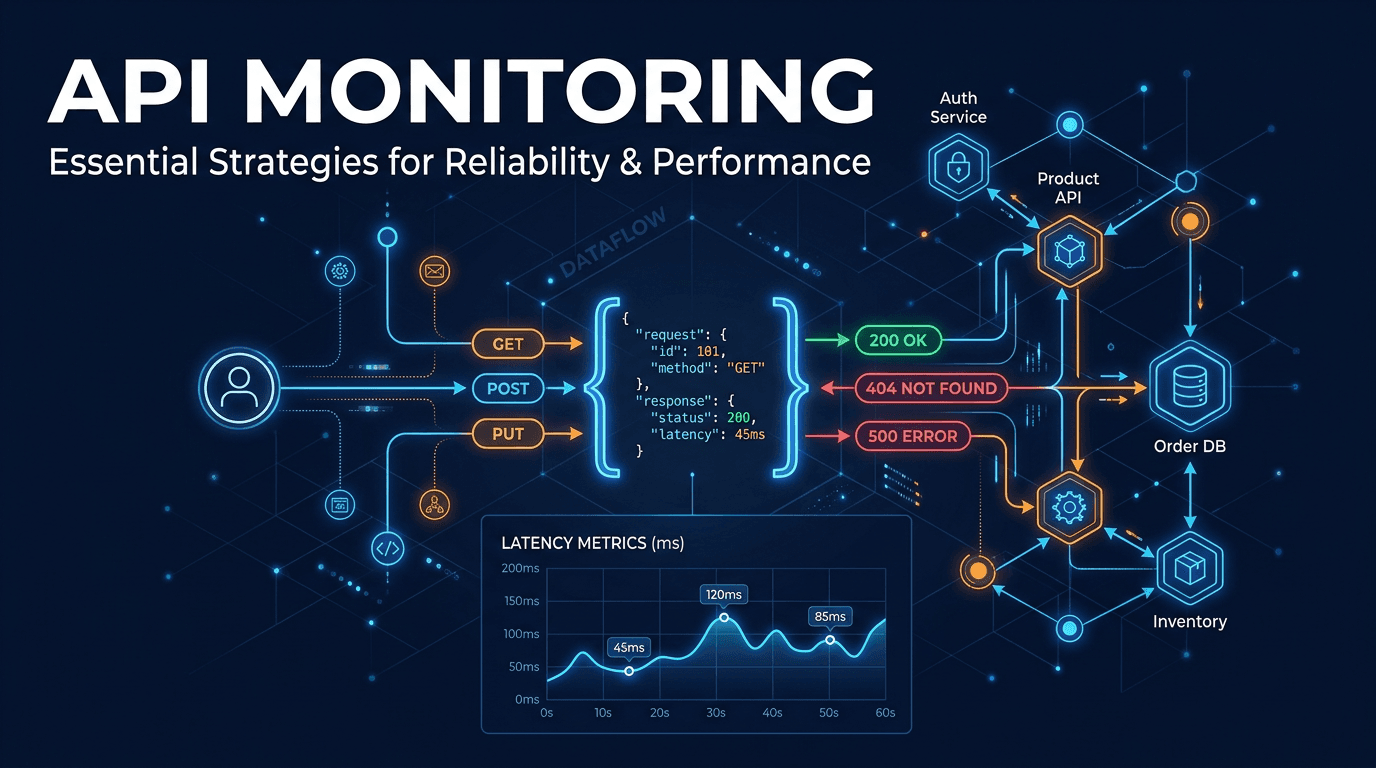
Leitfaden zur API-Überwachung: Verfügbarkeit, Leistung und Antwortvalidierung
Vollständiger API-Überwachungsleitfaden – Überwachen Sie REST- und GraphQL-Endpunkte auf Verfügbarkeit, validieren Sie Antwortschemata, verfolgen Sie Leistungsmetriken und erkennen Sie Fehler, bevor Benutzer betroffen sind.
Diese API-Überwachung-Übersicht bündelt die neuesten UpScanX-Artikel – vom Interesse zur Umsetzung, ohne das gesamte Archiv durchsuchen zu müssen. Seite 1 zeigt bis zu 20 von 13 Beiträgen zu diesem Thema.
Zuverlässigkeit löst kaum ein Team mit einem einzelnen Check. Es braucht klare Verantwortung, sinnvolle Alerts, Trendanalyse und die Verknüpfung technischer Signale mit Nutzerwirkung. Deshalb bleiben thematische Seiten dauerhaft nützlich.
Mehrere Blickwinkel zum selben Thema helfen, Ansätze zu vergleichen – ob Uptime, weniger Alert-Lärm, mehr Sicherheit oder skalierbare Operations.
Die stärksten Beiträge betonen pragmatische Systeme, messbare Trade-offs und wiederholbare Gewohnheiten: was überwachen, wie alarmieren, Ausfallzeiten vermeiden und wie Engineering-Entscheidungen das Geschäft beeinflussen.
Nutzen Sie die Seite als kurzen Lernpfad: zuerst der Artikel, der am Problem am nächsten ist, dann verwandte Guides.